原文见笔者个人网站 www.liangxiao.pro。内容经AI校正和润色,可能存在不准确之处,仅供研究参考。
免疫肽组学现在是肿瘤抗原发现里少数能给出直接证据的技术。斯特拉斯堡大学 Carapito 实验室与根特大学 Martens 实验室合作的这篇 bioRxiv 预印本,把免疫亲和纯化、色谱分离、采集参数与计算重打分这四件事放在同一台 timsTOF Ultra 2 上做了端到端的系统评估[1]。这条技术线的价值源头可以追到 2016 年——黑色素瘤组织上第一批天然呈递的新表位就是被质谱直接读出来的[2],此后十年免疫肽组学从“能不能做”走到了“能做多深”[3]。timsTOF 平台的 PASEF 采集凭高离子利用率成了这个领域的主力机型,但流程的改进此前一直是各改各的:磁珠半自动富集协议改样品制备[4],HLA 定制的多边形采集窗口改前体选择[5],重打分管线改鉴定置信度[6][7],很少有人把整条链放在同一台机器上一次讲清。
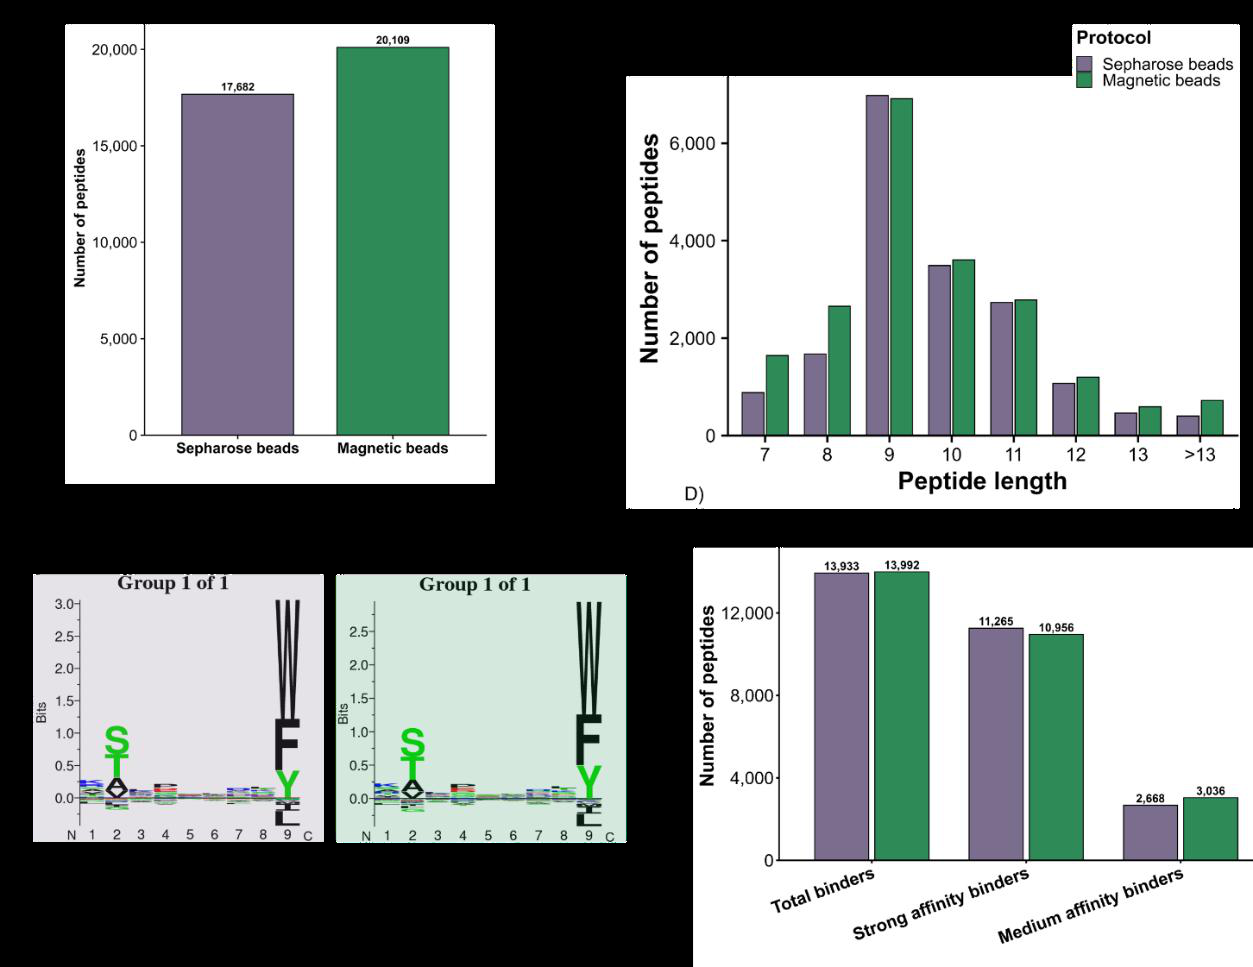
样品制备一环,作者把 CNBr 活化 Sepharose 珠的经典协议与 MagReSyn 蛋白 A 磁珠协议做了对照:前者用 6 亿个 HL60 细胞、注射 3,000 万细胞当量,后者用 6,000 万细胞、注射 1,500 万细胞当量。起始材料少十倍、上样量减半,磁珠协议反而多出约 14% 的鉴定——20,109 对 17,682 条肽,9-mer 主导的长度分布、GibbsCluster 聚出的 motif、NetMHCpan 预测的强中结合肽数量都保持一致。作者在讨论里主动提醒:起始量、上样量和处理步骤都不相同,这是端到端的流程评估而不是协议对照,改善不能全归给磁珠材料本身——毕竟免疫沉淀方案本身就会重塑肽组构成[8]。这句保留比那个 +14% 更值得记住。
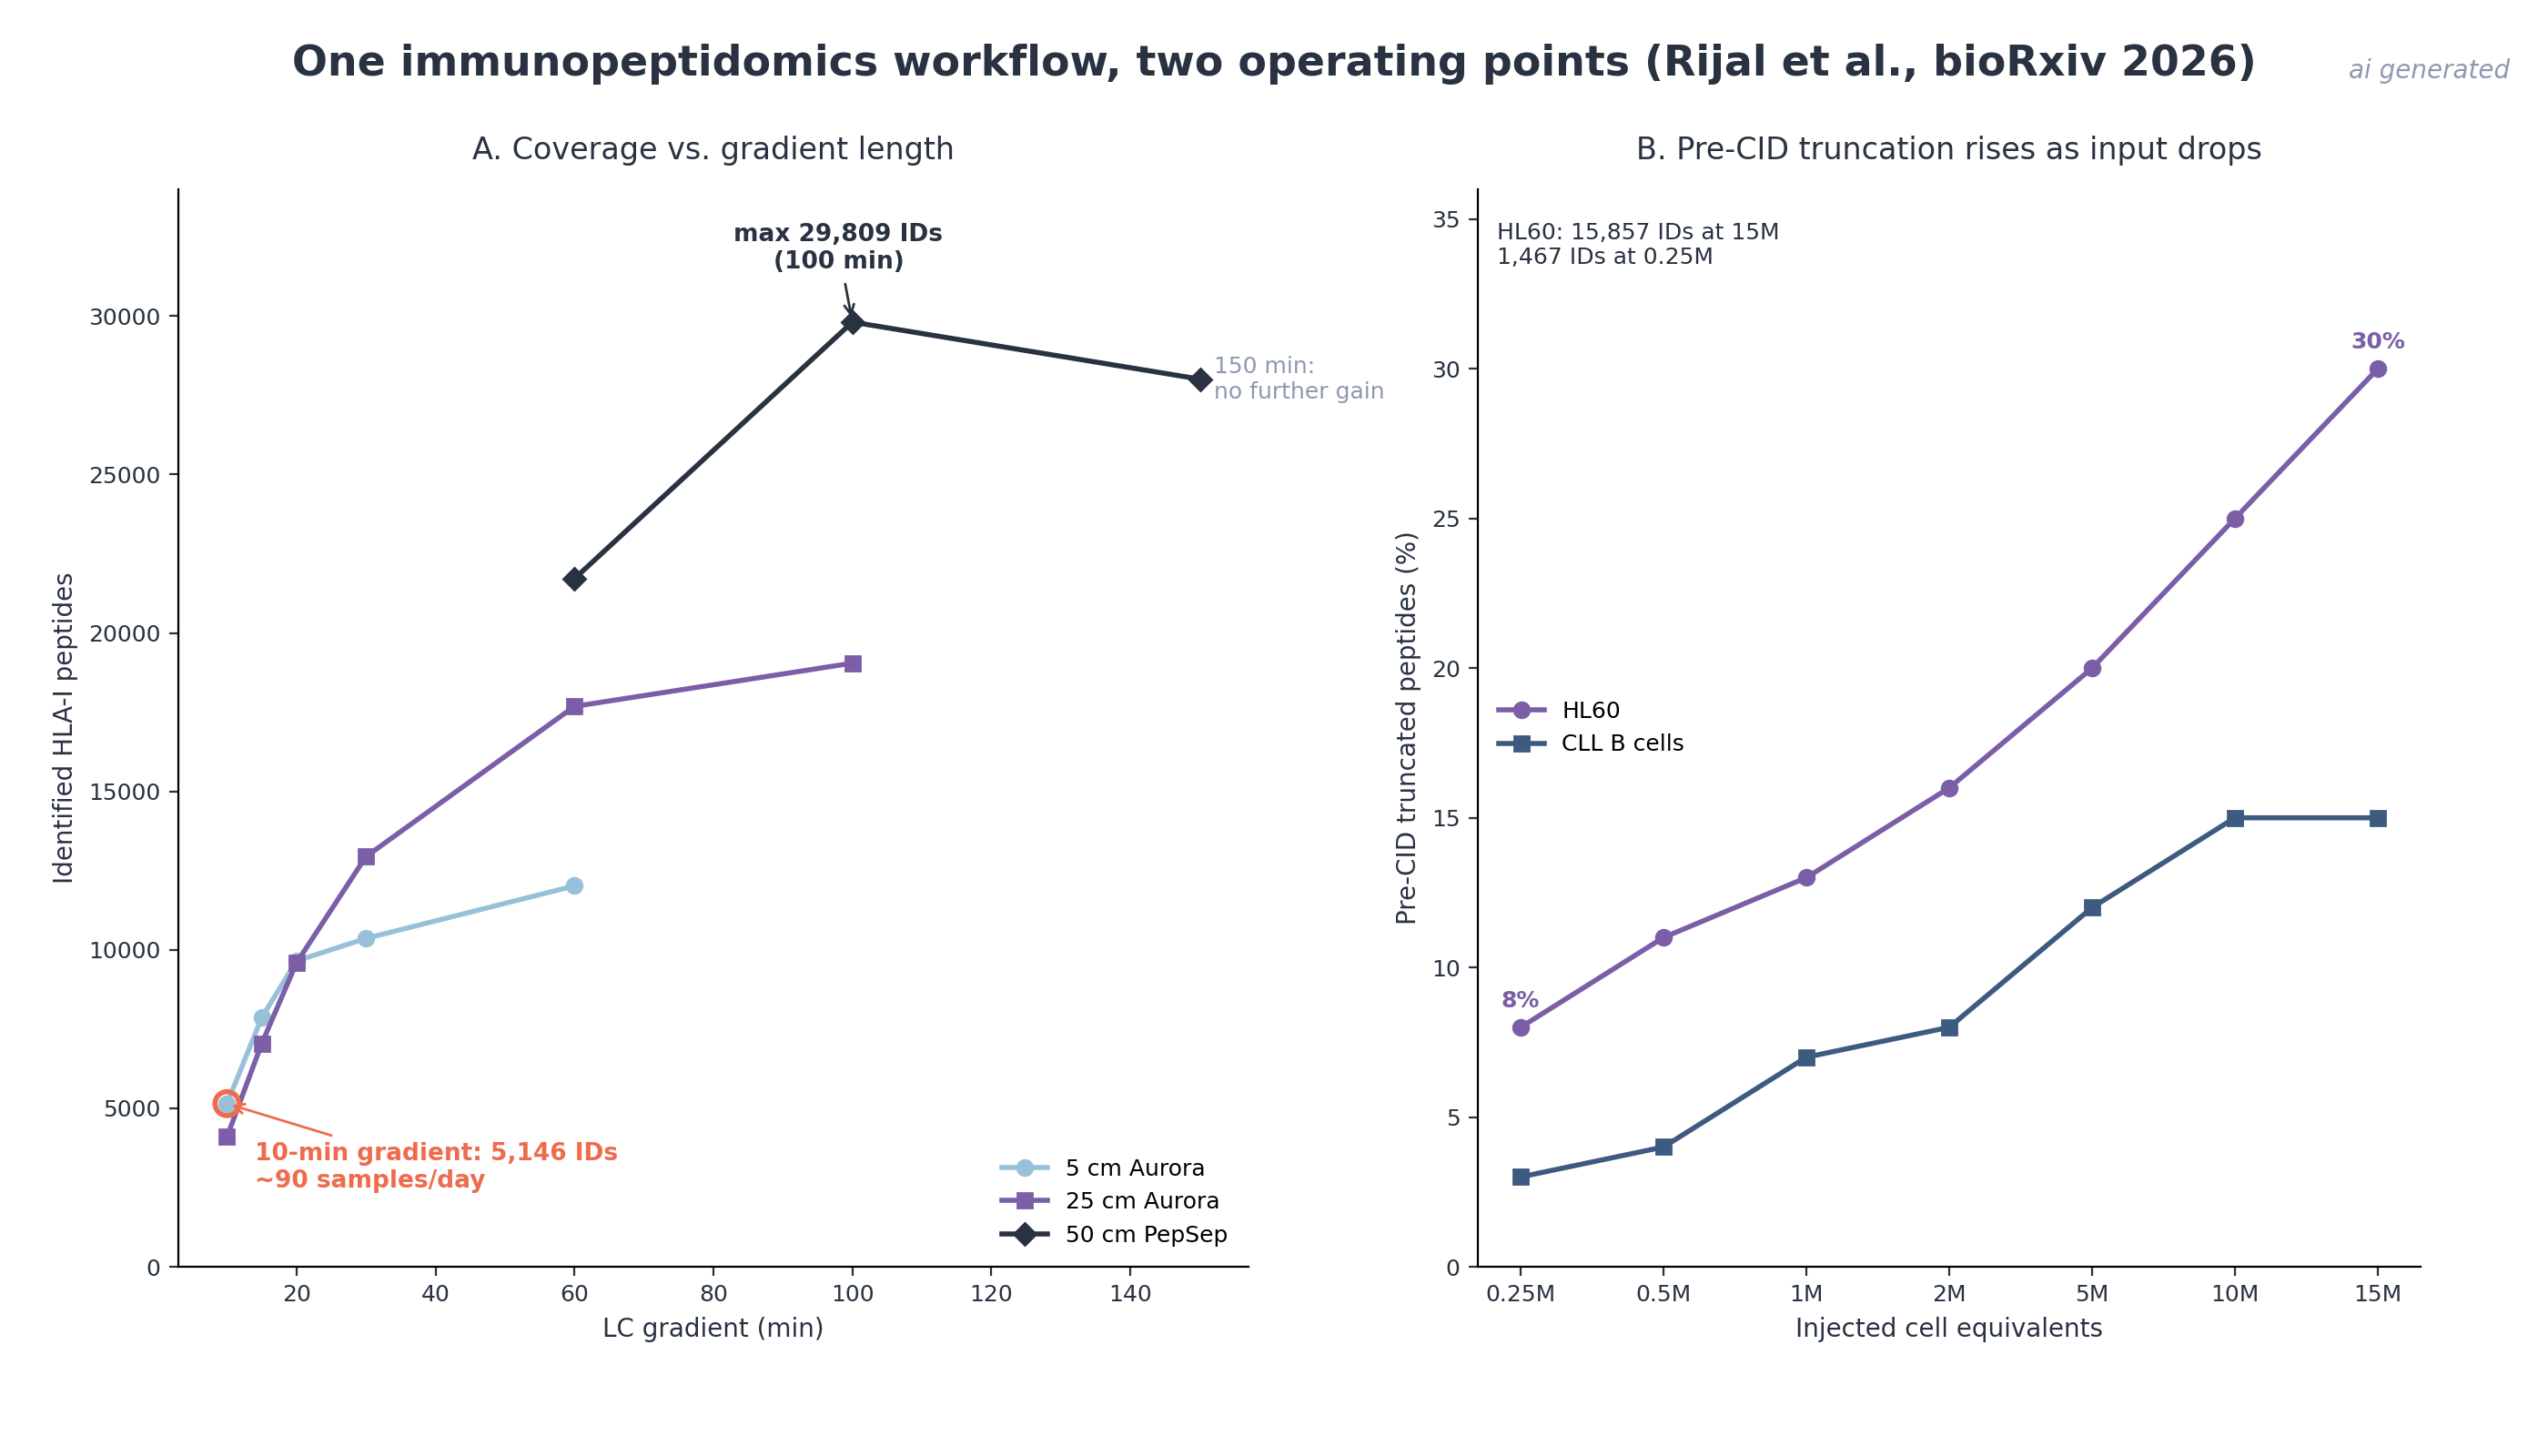
色谱层面的问题是每种应用都要回答的:多深算够、多快算快。作者扫了 10 到 150 分钟共七档梯度和 5、25、50 cm 三种柱长,结论不是“哪个最好”而是两档互补的配置。通量档用 5 cm Aurora 柱加 10 分钟梯度,单针 5,146 条肽、一天约 90 个样本;深度档用 50 cm PepSep 柱加 100 分钟梯度,29,809 条肽,是全实验的最高点,而再延到 150 分钟反而回落到 28,009——这条曲线在 100 分钟就封顶了。比鉴定数更有信息量的是电荷态分布随梯度的系统漂移:梯度越短,单电荷肽占比越高(5 cm 柱从 10 分钟的 51% 降到 60 分钟的 32%,25 cm 柱从 39% 降到 22%)。这个看似枝节的现象实际上为后面的碰撞能量优化埋了伏笔。
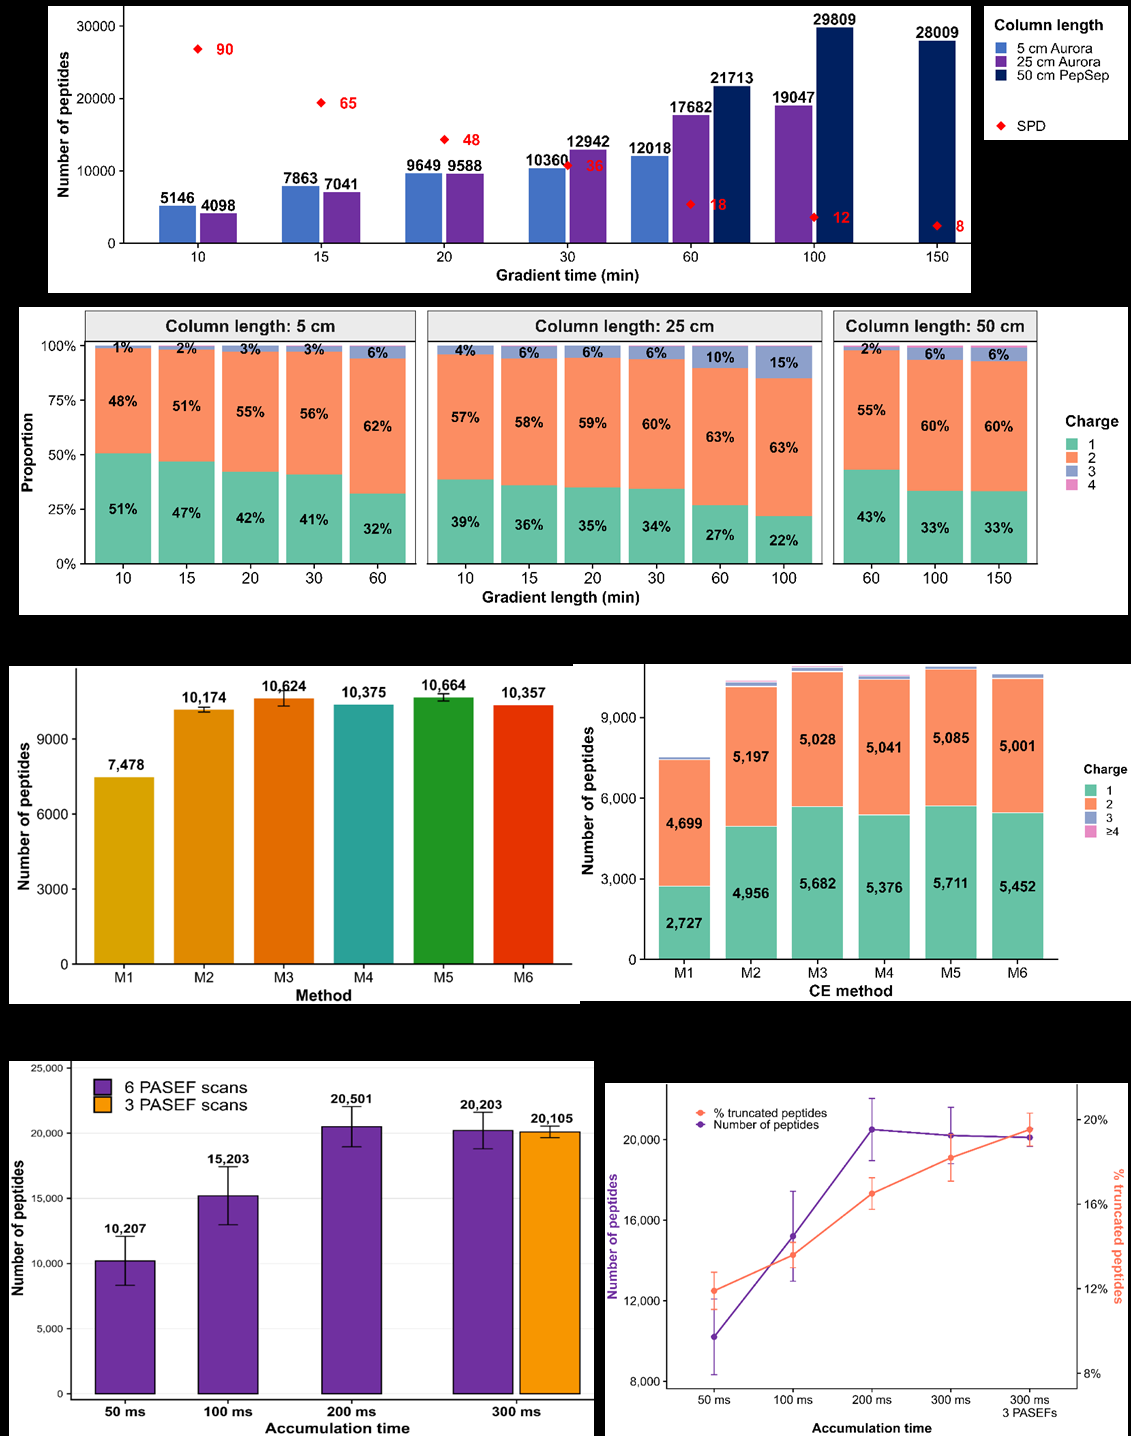
采集参数的优化给出了全文最扎实的一组数字。碰撞能量上,作者试了六条剖面,结果单电荷 HLA-I 肽对碰撞能量最敏感:能量不足的 M1 在 1.2–1.7 1/K₀ 区间只捞起 2,727 条单电荷肽,充分碎裂的 M5 拿到 5,711 条,两倍以上的差距,而双电荷肽同期只增加 8%——用常规胰蛋白酶多电荷肽调出来的线性 CE ramp,照搬到非酶切的免疫肽组上会系统性饿死单电荷这一群。累积时间从 50 ms 拉到 200 ms,鉴定数从 10,207 翻到 20,501,300 ms 则不再有增益;代价是 pre-CID 截断比例随累积时间一路上行,200 ms 之后的增加不再换来鉴定数——这个平衡点选在 200 ms 加 6 次 PASEF 扫描。pre-CID 截断值得多说一句:天然配体在意图外的提前碎裂会产生只差一两个末端残基的“假序列”,在无酶切检索里它们完全可以冒充生物来源的 HLA 配体,这正是 HLA 配体组学陷阱文献里警告过的伪多样性[9];把 pre-CID 比例当作优化目标显式监控,是这篇方法学论文里最有推广价值的一个 QC 动作。另外,这里选出的 200 ms/6 扫描与 Thunder 在 timsTOF Pro 2 上给出的 300 ms/3 帧并不一致,作者明确说这不能读成矛盾——机型、样品、色谱都不同,参数从一台 timsTOF 搬到另一台必须重新评估。
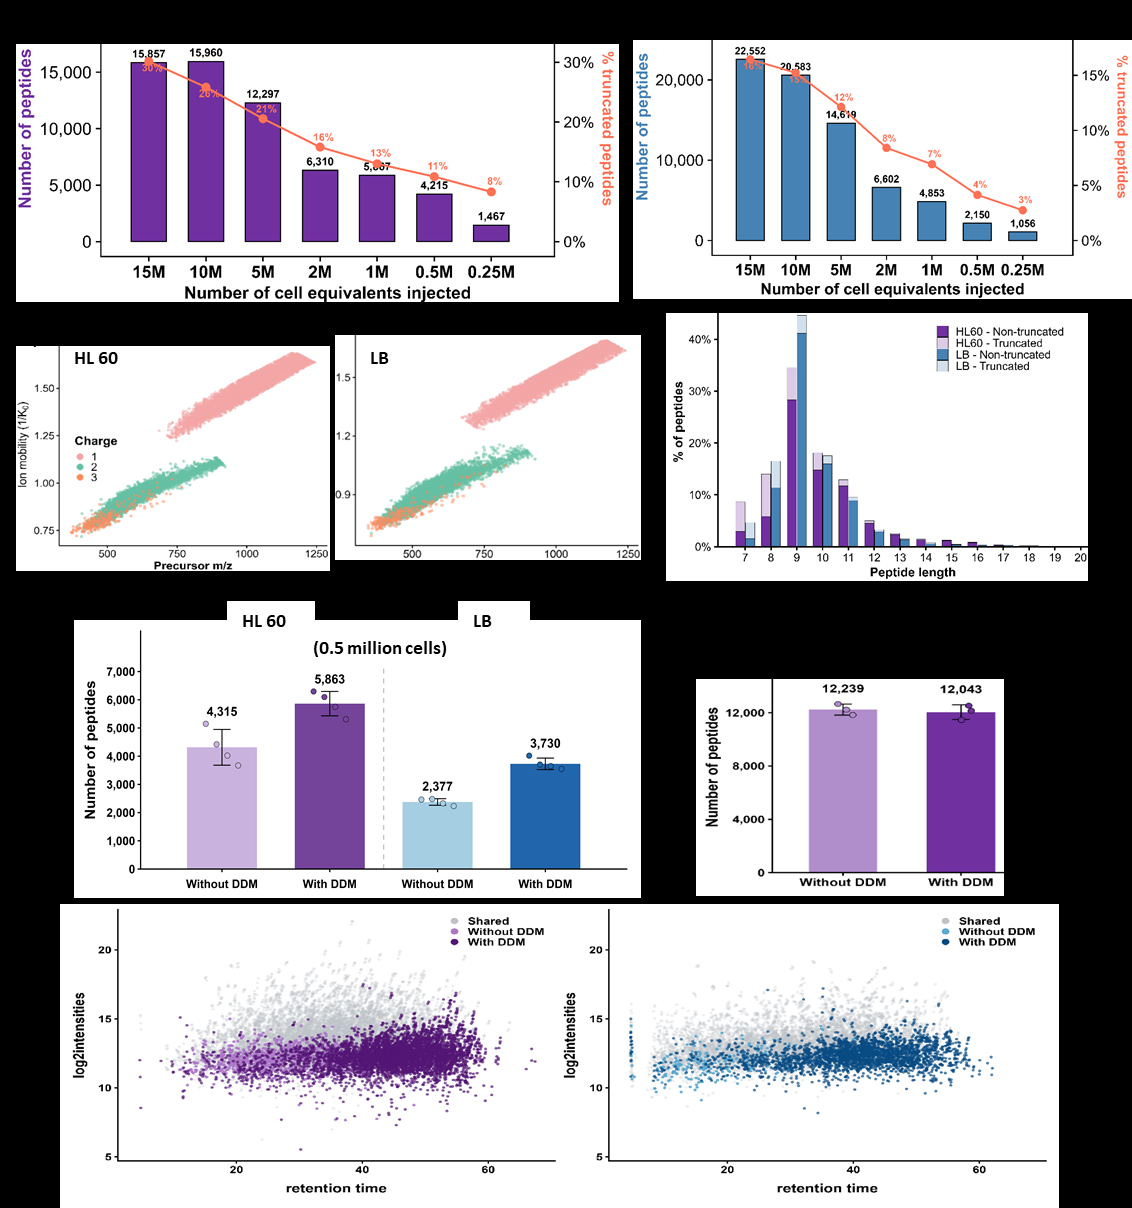
计算侧收尾用的是 TIMS²Rescore——MS²Rescore 框架的 timsTOF 定制版,把 DeepLC 保留时间与 MS²PIP timsTOF 碎裂预测揉进 mokapot 的半监督 FDR 估计;重打分在全部稀释系列上稳定增益,且新增肽段保留了 9-mer 主导与正常 motif。灵敏度端,HL60 稀释系列从 1,500 万细胞当量一路压到 25 万:15,857 条肽降到 1,467 条,100 万细胞当量时仍有 5,807 条;CLL 患者富集的 B 细胞在 Ultra 的 AIP 配置下从 22,552 降到 1,056,pre-CID 截断比例随上样下降从 30% 缩到 8%(B 细胞 15% 到 2%)。低投入端还有一个简单的增益件:0.015% 的 DDM 把 50 万细胞当量的 HL60 鉴定从 4,315 提到 5,863(+35%),B 细胞从 2,377 提到 3,730(+57%),而 500 万输入时不再有收益;DDM 换来的肽偏疏水、强度偏低,指向的是表面吸附损失的补偿。此前低投入免疫肽组学文献里 DDM 的效果有正有负,作者把这称作免疫肽组学语境下首个直接证明[10]。
| 深度优先 | 通量优先 | |
|---|---|---|
| 色谱柱 | 50 cm PepSep | 5 cm Aurora |
| 梯度 | 100 min | 10 min |
| 单针鉴定 | 29,809 条肽 | 5,146 条肽 |
| 吞吐 | 约 12 样本/天 | 约 90 样本/天 |
方法学细节的成色之外,这份预印本有几处软肋值得摆出来。柱长与梯度的那组关键比较没有呈现重复进样的误差棒,两档配置的选择在相当程度上建立在单次运行上;主战场始终是 HL60 一条细胞系加上 CLL 患者的 B 细胞,摘要里“支撑未来临床应用”的允诺,还没有在任何真正稀缺的临床样本——穿刺活检、有限 PBMC——上兑现过。磁珠比较的混杂因素作者自己承认了,但摘要口径仍以“改善”作主语,读者容易读成材料本身的功劳。重打分依赖的 DeepLC 与 MS²PIP 模型用保留性质正常的肽训练得很好,“新增肽段维持 9-mer 主导”是安慰性检查而非无偏证明——模型偏好与训练分布相近的肽,这意味着非常规肽段(大修饰、非典型长度或非常见基序)可能在重打分的闸门外被系统性压低,对做 ncORF 或 PTM 免疫肽组的人,这是一个值得记住的方向性偏置。pre-CID 的判定也依赖“截去一两个末端残基后匹配到更长鉴定肽”这个操作性定义,母肽本身未被鉴定的截断肽会漏判。最后,作者在讨论里诚实写明:不同研究之间的鉴定绝对数不可比——细胞类型、HLA 基因型、抗体组合、搜索引擎都在变。这句克制放在“平台军备竞赛”惯常的语境里,比任何参数都珍贵。
对日常跑 timsTOF 的免疫肽组学实验室,这篇论文有三个可以直接搬走的东西:单电荷肽的碰撞能量要按 1/K₀ 高迁移率区单独调,不能沿用胰蛋白酶方法的 ramp;累积时间的灵敏度收益在 200 ms 封顶,而且要盯住 pre-CID 比例而不只是鉴定数;低投入样本值得试一次 DDM。更方法论的那条是机器间的参数不可迁移性——它提醒所有从 Pro 2 向 Ultra 过渡的实验室,以及任何把“标准方法”当免检标签的审稿流程。往大处看,这项工作把免疫肽组学的样本门槛从数亿细胞压到了 25 万细胞当量仍有千余条肽,临床样本“够不够做”的定义正在被重写;但真正的那一步——在活检组织上端到端跑通并回答临床问题——还没有发生在这篇预印本里。参数表已经备好,考题还没有换成真实的。
参考文献
- Rijal JB, Hirschler A, Declercq A, Sommer M, Keller C, Jung A, Burel A, Fornecker L-M, Rolland D, Gabriels R, Martens L, Carapito C. Finely tuned DDA-PASEF-based immunopeptidomics workflow enhances HLA class I coverage. bioRxiv. 2026. DOI: 10.64898/2026.11.03.761330
- Bassani-Sternberg M, Bräunlein E, Klar R, Engleitner T, Sinitcyn P, Audehm S, et al. Direct identification of clinically relevant neoepitopes presented on native human melanoma tissue by mass spectrometry. Nat Commun. 2016;7:13404. DOI: 10.1038/ncomms13404
- Chong C, Coukos G, Bassani-Sternberg M. Identification of tumor antigens with immunopeptidomics. Nat Biotechnol. 2022;40:175–188. DOI: 10.1038/s41587-021-01038-8
- Lim Kam Sian TCC, Goncalves G, Steele JR, Shamekhi T, Bramberger L, Jin D, et al. SAPrIm, a semi-automated protocol for mid-throughput immunopeptidomics. Front Immunol. 2023;14:1107576. DOI: 10.3389/fimmu.2023.1107576
- Gomez-Zepeda D, Arnold-Schild D, Beyrle J, Declercq A, Gabriels R, Kumm E, et al. Thunder-DDA-PASEF enables high-coverage immunopeptidomics and is boosted by MS2Rescore with MS2PIP timsTOF fragmentation prediction model. Nat Commun. 2024;15:2288. DOI: 10.1038/s41467-024-46380-y
- Declercq A, Bouwmeester R, Hirschler A, Szytel L, Rijal JB, Carapito C, et al. MS2Rescore: Data-Driven Rescoring Dramatically Boosts Immunopeptide Identification Rates. Mol Cell Proteomics. 2022;21:100266. DOI: 10.1016/j.mcpro.2022.100266
- Declercq A, et al. TIMS²Rescore: A Data Dependent Acquisition–Parallel Accumulation and Serial Fragmentation–Optimized Data-Driven Rescoring Pipeline Based on MS2Rescore. J Proteome Res. 2025;24:1067–1076. DOI: 10.1021/acs.jproteome.4c00609
- Wacker M, Bauer J, Wessling L, Dubbelaar M, Nelde A, Rammensee HG, et al. Immunoprecipitation methods impact the peptide repertoire in immunopeptidomics. Front Immunol. 2023;14:1219720. DOI: 10.3389/fimmu.2023.1219720
- Fritsche J, Kowalewski DJ, Backert L, Gwinner F, Dorner S, Priemer M, et al. Pitfalls in HLA Ligandomics—How to Catch a Li(e)gand. Mol Cell Proteomics. 2021;20:100110. DOI: 10.1016/j.mcpro.2021.100110
- Nie S, O’Brien JR, Livson Y, Greer T, Zheng X, Li N, et al. Maximizing hydrophobic peptide recovery in proteomics and antibody development using a mass spectrometry compatible surfactant. Anal Biochem. 2022;658:114924. DOI: 10.1016/j.ab.2022.114924
内容经AI校正和润色,审慎阅读