本文由WorkBuddy Agent撰写并直接通过WordPress API发布于笔者个人网站www.liangxiao.pro。内容可能存在不准确之处,仅供研究参考。
免疫肽组学的瓶颈不在采集而在鉴定。HLA-I配体是蛋白酶体剪出的8到12个氨基酸非胰酶肽段,电荷态偏低,碎裂常常不完全,大量二级谱图无法得到可信归属[1]。与常规蛋白质组学不同,这里没有用多条肽推断一个蛋白的冗余:肽段本身就是分析物,也是候选治疗靶点,一条配体没被鉴定,就等于一个靶点不存在[1]。扩大鉴定量的努力大多投在富集与数据分析端,碎裂方式这个参数反而极少被碰——蛋白质组学早知没有一种激活方式能覆盖所有肽段类别[2],免疫肽组学却几乎默认HCD一种激活走天下,EThcD与UVPD只有零星探索[3][4]。9月30日,莫纳什大学与Hudson医学研究所Pouya Faridi团队联合Thermo Fisher在bioRxiv贴出一项系统比较,在集成红外激光的Orbitrap Tribrid Apex MultiOmics上,把离子阱CID与红外多光子解离(IRMPD)同HCD一起放回HLA-I免疫肽组学的检验台[1]。
实验设计相当克制:四种HLA分型细胞系(两株EBV转化B淋巴母细胞系、结直肠癌HCT116、三阴性乳腺癌MDA-MB-231)各以三种碎裂方式做技术重复,共45个raw文件;HLA肽段经W6/32免疫亲和纯化,半自动SAPrIm流程完成捕获与洗脱[1]。真正的方法论自觉在检索之后:碎片离子强度与保留时间预测器几乎全部由HCD谱图训练,直接拿这把HCD形状的尺子去量CID与IRMPD,必然低估后者,方法级微调不是锦上添花而是公平比较的前提[1]。作者对每个细胞系×方法组合单独微调AlphaPeptDeep[5]的谱图与保留时间模型,再经Percolator重排序[6]:重打分在全部12种组合中带来增益,经典库中位+17.1%(两株癌细胞系最高+42.6%),Ribo-seq来源暗库中位+54.5%——作者随即坦承暗库百分比偏大主要是分母效应,暗库每组合中位仅89条肽,与经典库的7648条差着两个数量级[1]。五个数据集合并微调的master模型与逐数据集模型差距不超过±0.5%,连HeLa弹性酶切(非HLA洗脱)上训练的模型也能近零损失迁移,说明微调学到的主要是碎裂行为而非样本生物学[1]。
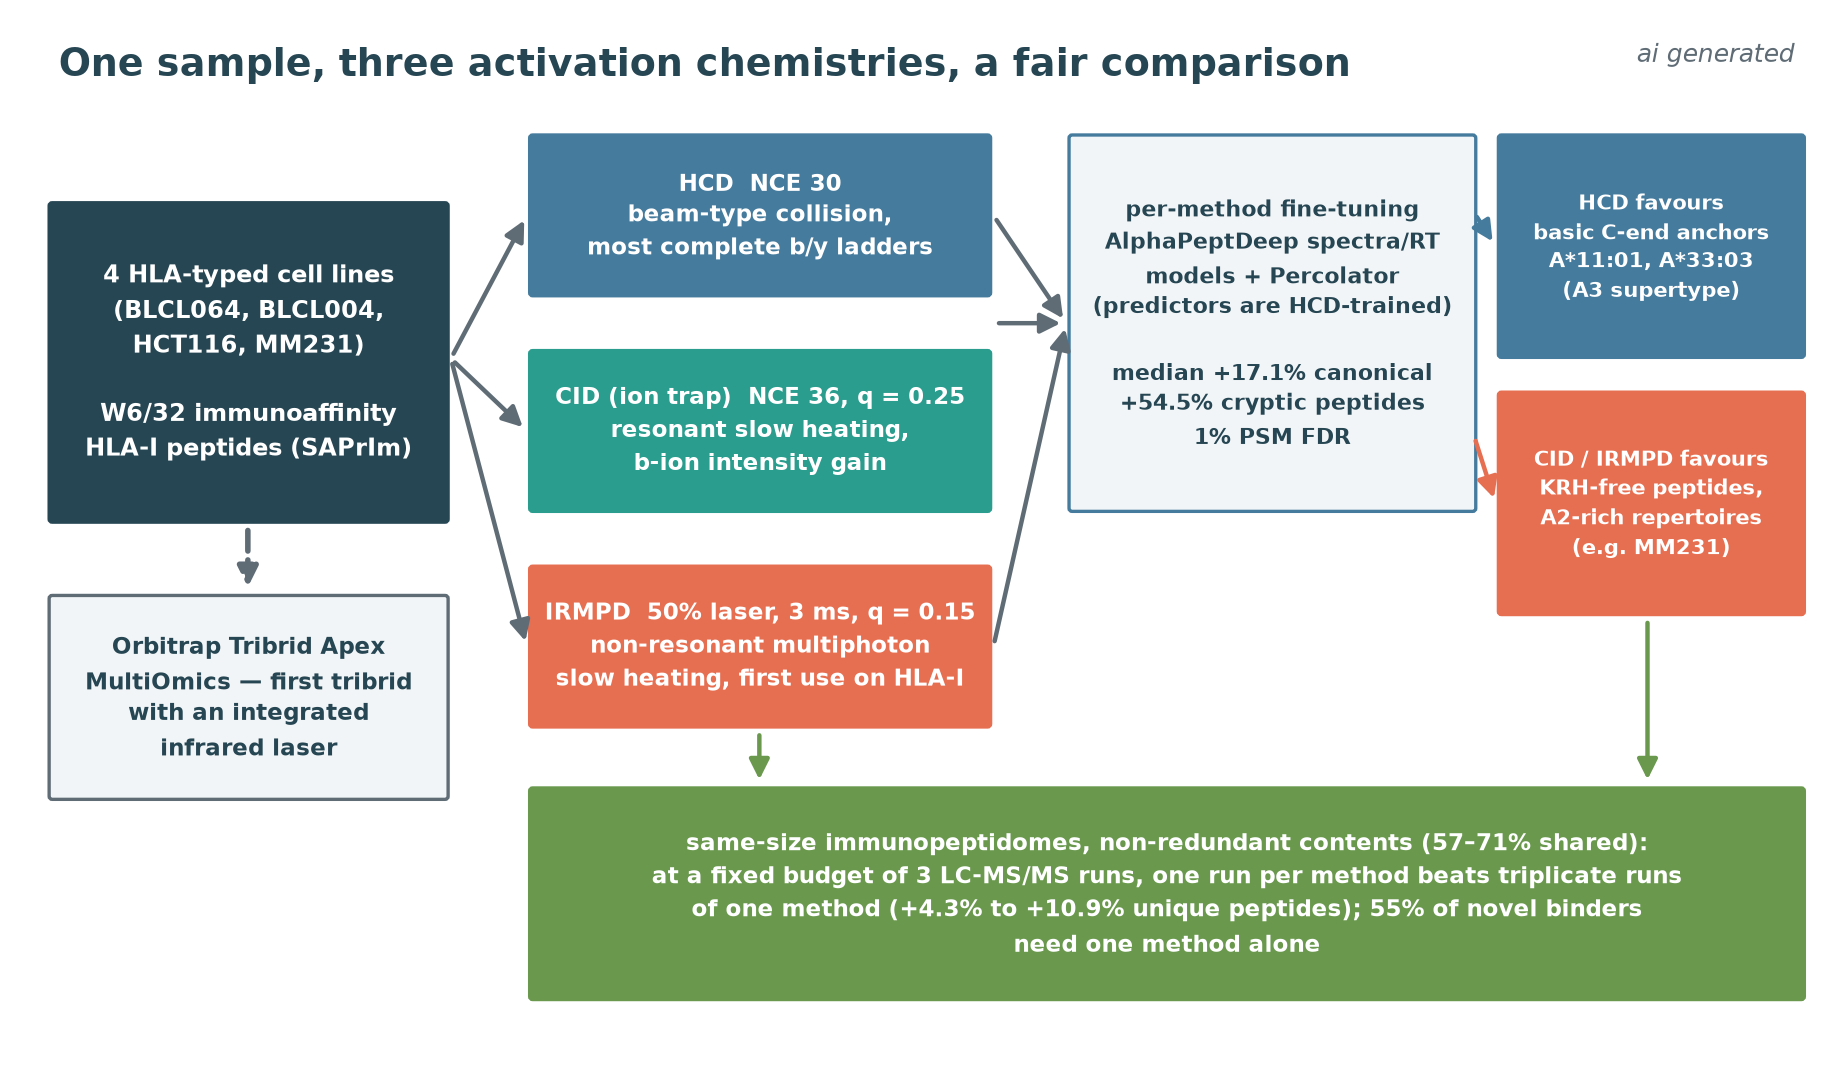
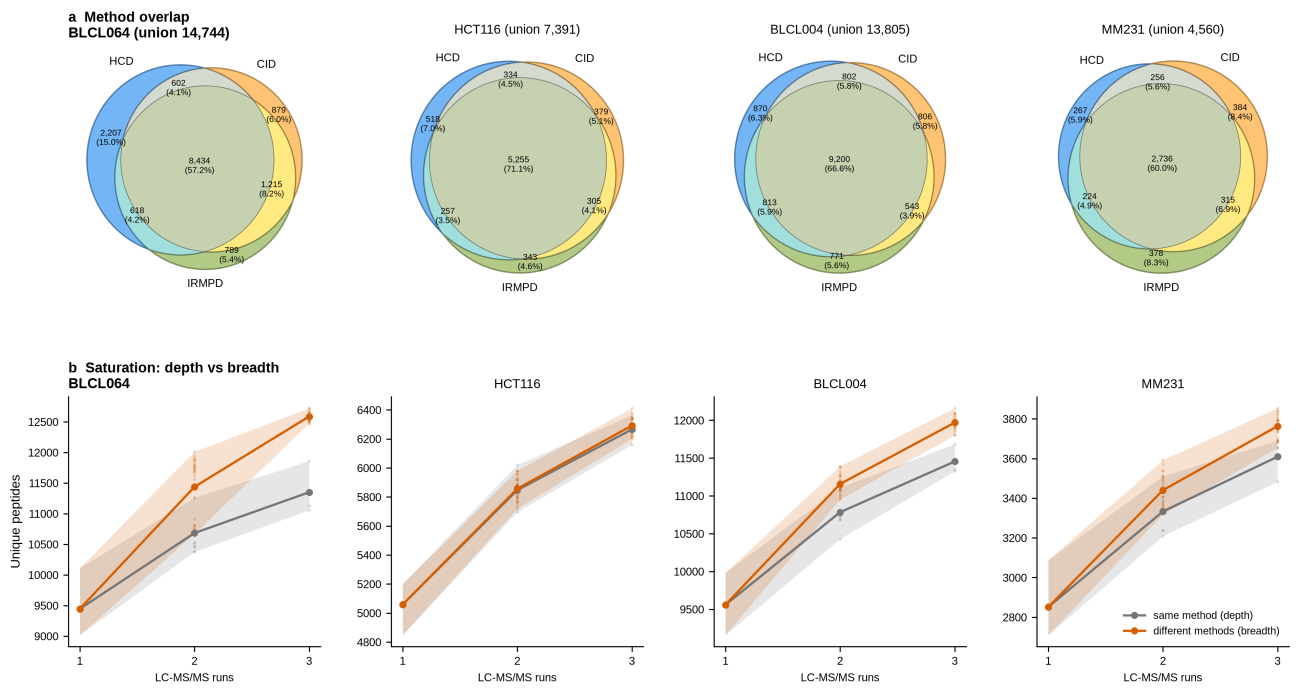
三种方法得到的免疫肽组规模确实相当:细胞系内方法间差异不足7%,93.2%到97.8%的肽段可被NetMHCpan 4.2预测为结合肽,等位基因构成、肽长与序列motif几乎不随方法改变[1]。但这是规模的平等,不是内容的冗余:57.2%到71.1%的肽段为三法共有,余下部分就是各自的盲区。互补性沿三个层面展开。谱图层面,HCD的b/y离子梯最完整(36%的9-mer兼具全b梯与全y梯,CID与IRMPD分别只有22%与20%),CID与IRMPD则把信号集中到更少的碎片上,单个离子更强、搜索得分更高[1]。等位基因层面,HCD在C端碱性锚定等位基因上优势明显:A11:01(88%的配体C端为赖氨酸)被HCD检出84%,CID与IRMPD只有73%与74%,A33:03(94%精氨酸)同向;而MM231的六个等位基因无一需要碱性C端锚定,全部偏向CID与IRMPD。21个受试等位基因上,检出份额差异与C端K+R频率的相关性达Spearman r=-0.52(CID)与-0.45(IRMPD)[1]。
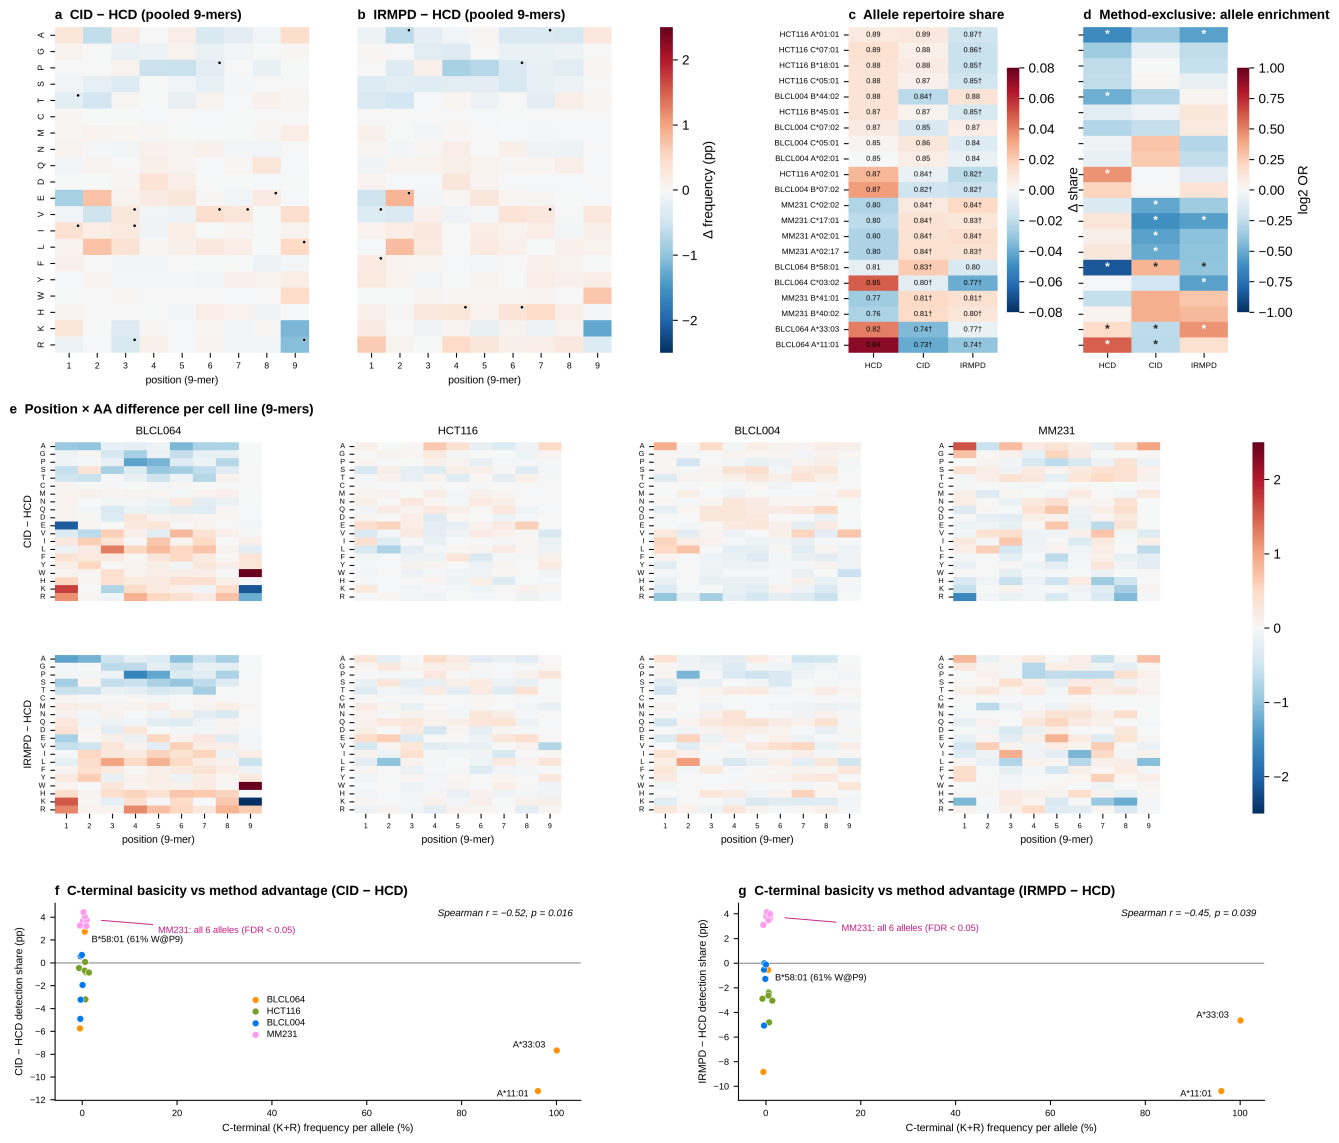
机制最终落在移动质子模型[7]上一段干净的物理:C端带赖氨酸或精氨酸的肽把质子锚定在C端,y离子主导;完全不含K、R、H的KRH-free肽在移动质子机制下碎裂,b/y电流近乎均分,慢加热方式对这类肽给出更高的得分与更强的匹配离子电流。作者枚举人类蛋白组全部约1360万条KRH-free 8-12mer,其中约262万条可预测结合九大经典超型:A2超型独占64万条,而要求C端碱性残基的A3超型只剩3.3万条——HLA超型化学就这样预先决定了碎裂方式的收益分布,实际洗脱数据中A2超型分派配体的22.6%到36.8%不含任何碱性残基[1]。配对比较显示,KRH-free肽在CID下MSFragger得分中位高出2.8到4.4,同一肽段SVDVTNTTF在BLCL004中CID得分14.1对HCD的2.1;鉴定层面,A2主导的MM231中CID回收了KRH-free集合的85.4%,HCD只有60.9%[1]。作者的这句结论值得记录:常被归咎于CID的y离子偏好,其实是肽的性质而非方法的性质[1]。
实用层面,这篇工作给出两个可操作的数字。其一,同一台仪器、同样三轮LC-MS/MS,把预算摊给三种方法各一轮,比单方法三针重复平均多出0.4%到10.9%的独特肽段(暗库增益最高+32%);单方法重复的边际收益第二针就衰减到+13.7%、第三针只剩+6.4%,方法多样性买来的正是盲区[1]。其二,两种癌细胞系中239条IEDB未收录的新预测结合肽里,55%仅被单一方法检出;9条来自已知肿瘤相关抗原的新配体——IGF2BP3 EEIPLKILA、TOP2A RETEPRRAA、CCNB1 REVTGNMRA、癌睾抗原TTK YDYEITDQY等——只有3条能被纯HCD流程发现[1]。修饰层面亦有信号:磷酸化肽在IRMPD下亏空(q=0.056,勉强过线),赖氨酸乙酰化在IRMPD下富集(q=0.043),泛素化diGly残留则仍以HCD最佳[1]。
| 维度 | HCD | 离子阱CID | IRMPD |
|---|---|---|---|
| 能量沉积 | 束型碰撞,快速高能 | 共振慢加热(q=0.25) | 非共振多光子慢加热(q=0.15) |
| 离子梯完整性 | 最完整,36%的9-mer双全梯 | 22%,N端首键覆盖率75% | 20%,多靠b/y合并覆盖 |
| 强度分布 | 较分散,y1突出 | b8增强,强度集中 | 强度集中,y离子强度下降 |
| 优势肽段与等位基因 | C端碱性锚定(A3超型:A11:01、A33:03) | 无碱性C端锚定肽段;MM231全部六个等位基因 | KRH-free肽段;单电荷前体效率高 |
| 修饰回收 | 磷酸化与diGly最佳 | 磷酸化与HCD相当 | 磷酸化亏空,赖氨酸乙酰化富集 |
以笔者之见,这篇预印本的可贵与可议同样分明。可议者三。其一,摘要称CID与IRMPD”均属首次”应用于HLA-I免疫肽组学,而引言自己承认离子阱CID”早已被使用”于这一领域,UVPD亦有HLA-A02:01的应用先例[4];准确的表述应是首次系统比较与IRMPD首用,摘要的修辞超出了证据。其二,全部数据来自四株细胞系的高上样量,且IR激光眼下集成于Apex MultiOmics、离子阱CID亦需三合一平台,这一组合目前仅此一家;三位Thermo雇员与通讯作者的Thermo KOL身份,提醒读者把”实用建议”的适用半径看得更小——多数免疫肽组学实验室手中的Exploris或Astral级平台并不具备这套硬件。其三,239条新结合肽止步于NetMHCpan预测与IEDB缺席,没有免疫原性验证,其转化价值仍在纸面。可贵的恰是同一批作者的不修饰:暗库增益的分母效应、HCT116中KRH-free优势整体缺席(归因于采集层面而非肽段层面)、排除两个碱性锚定等位基因后相关性衰减至r=-0.31(p=0.19)、A02:01在不同细胞系中方向翻转,这些不利或不确定的结果全部如实写出[1]——与预印本常见的选择性叙事相比,这几乎算得上一种美德。
文章真正的论点其实不在CID或IRMPD本身,而在基础设施:免疫肽组学的谱图预测器、重打分框架与采集方法都长成了HCD的形状,任何偏离HCD的碎裂化学都得先借这把尺子证明自己[1]。作者的处方是把基础设施换成方法原生的——为CID与IRMPD训练专属强度模型,按前体性质分配激活方式,进而评估DIA场景下更低的化学背景能否帮助解析高度多路复用的谱图[1][8]。AlphaPeptDeep——出自西湖大学曾文峰等人的深度学习框架[5]——在此被用作迁移学习的载体,其跨细胞系近零损失的迁移能力提示,方法级模型库是一条低成本路径。对免疫肽组学从业者,这篇预印本的短期价值不在”换方法”,而在提醒地图的边界:A2是全球最常见的超型之一,其配体近四分之一到三分之一不含碱性残基,这部分配体组是否被HCD-only流程系统性低估,在把候选抗原清单交付给疫苗与T细胞疗法之前,值得先问一句。碎裂化学补上的不只是几十条新肽,而是把”免疫肽组覆盖到哪”这个问题的答案,从仪器默认设置的手里接了回来。
参考文献
- Lim Kam Sian TC, Salvato F, Selvakumar N, Shamekhi T, Hinkle J, Mullen C, Goncalves GA, Schittenhelm RB, Faridi P. Beyond HCD: complementary fragmentation chemistries expand HLA class I immunopeptidome discovery. bioRxiv 2026. doi:10.64898/2026.09.24.754253
- Shen Y. Effectiveness of CID, HCD, and ETD with FT MS/MS for degradomic-peptidomic analysis: comparison of peptide identification methods. J Proteome Res 2011. doi:10.1021/pr200052c
- Kessler AL, et al. Increased EThcD efficiency on the hybrid Orbitrap Excedion Pro mass analyzer extends the depth in identification and sequence coverage of HLA class I immunopeptidomes. Mol Cell Proteomics 2025;24:101049. doi:10.1016/j.mcpro.2025.101049
- Watts E, Potts GK, Ready DB, George Thompson AM, Lee J, Escobar EE, Patterson MJ, Brodbelt JS. Characterization of HLA-A*02:01 MHC immunopeptide antigens enhanced by ultraviolet photodissociation mass spectrometry. Anal Chem 2021;93:13134-13142. doi:10.1021/acs.analchem.1c01002
- Zeng WF, Zhou XD, Zhou W, et al. AlphaPeptDeep: a modular deep learning framework to predict peptide properties for proteomics. Nat Commun 2022;13:7238. doi:10.1038/s41467-022-34904-3
- Käll L, Canterbury JD, Weston J, Noble WS, MacCoss MJ. Semi-supervised learning for peptide identification from shotgun proteomics datasets. Nat Methods 2007;4:923-925. doi:10.1038/nmeth1113
- Wysocki VH, Tsaprailis G, Smith LL, Breci LA. Mobile and localized protons: a framework for understanding peptide dissociation. J Mass Spectrom 2000;35:1399-1406. doi:10.1002/1096-9888(200012)35:123.0.CO;2-R
- Shahbazy M, Ramarathinam SH, Illing PT, Jappe EC, Faridi P, Croft NP. Benchmarking bioinformatics pipelines in data-independent acquisition mass spectrometry for immunopeptidomics. Mol Cell Proteomics 2023;22:100515. doi:10.1016/j.mcpro.2023.100515
内容经AI校正和润色,审慎阅读