原文见笔者个人网站 www.liangxiao.pro。内容经AI校正和润色,可能存在不准确之处,仅供研究参考。
免疫肽组学里最诱人的靶点,恰恰是不写在基因组上的那些序列。蛋白酶体能把两段不相邻的片段缝在一起,组织蛋白酶能在酸性环境里做反式肽键,染色体易位把两个基因的接头翻成一段谁也没见过的肽。这些序列一旦成立,就意味着一个只属于肿瘤、或只属于某种自身免疫病的靶点;而且序列本身就是发现,疫苗与 TCR 立刻有了坐标。
麻烦在于,能解释一张谱图与只能由一条序列解释,是两件事。同质量的肽从来不止一条:一条由两段拼起来的十肽,母离子质量几乎总能被某条普通的基因组编码肽以完全相同的质量复现,后者不需要任何特殊机制,只需一次常规酶切。2016 年 Liepe 等报告 HLA-I 配体中有相当大比例是蛋白酶体剪接的产物[1],此后 Admon 质疑这类序列是否真的存在[2],Mylonas 等把剪接肽的贡献压得很低[3],Lichti 在胰岛数据里指出若干导致错误指认的机制[4];另一边,Faridi 等在黑色素瘤细胞系里找到了确实无法由基因组模板解释的配体[5]。争了十年,双方手里都有谱图,因为争的不是生物学而是判定规则:一张谱图要提供多少证据,才算把一条序列从可能的解释提升为唯一的解释。
Tabatabaei Dakhili、Hinse、Foster 与 Brömme 给出的 TransPepMS 把这套规则写成了软件[6]。值得一说的是作者阵容:Brömme 实验室长期做组织蛋白酶,本博客评述过的组织蛋白酶 K 反式肽键生成类风湿关节炎相关嵌合肽的工作就出自这里[7],而溶酶体组织蛋白酶经转肽生成 CD4 T 细胞可识别的嵌合表位,也是糖尿病领域的既有结论[8]。这不是外人拆台,是做这件事的人回头给自己装了一把尺子。
工具不提议任何序列。候选来自外部检索引擎,TransPepMS 只做一件事:把候选放到它所有同质量竞争者面前,看谁在这张谱图上握有的独有碎片离子更多。竞争池分四层,独立引擎对同一张谱图给出的另一条肽、参考蛋白组能编码的全部同质量肽、接点窗口内所有同质量重排、以及供体已知时两个供体能拼出的全部杂合体。判定用区分离子余量,即候选独有的 b/y 离子数减去最强竞争者独有的 b/y 离子数;不小于三则保留,被反超三个以上则拒绝,两者之间判为未决。三态而非二态,是这个工具最要紧的设计。
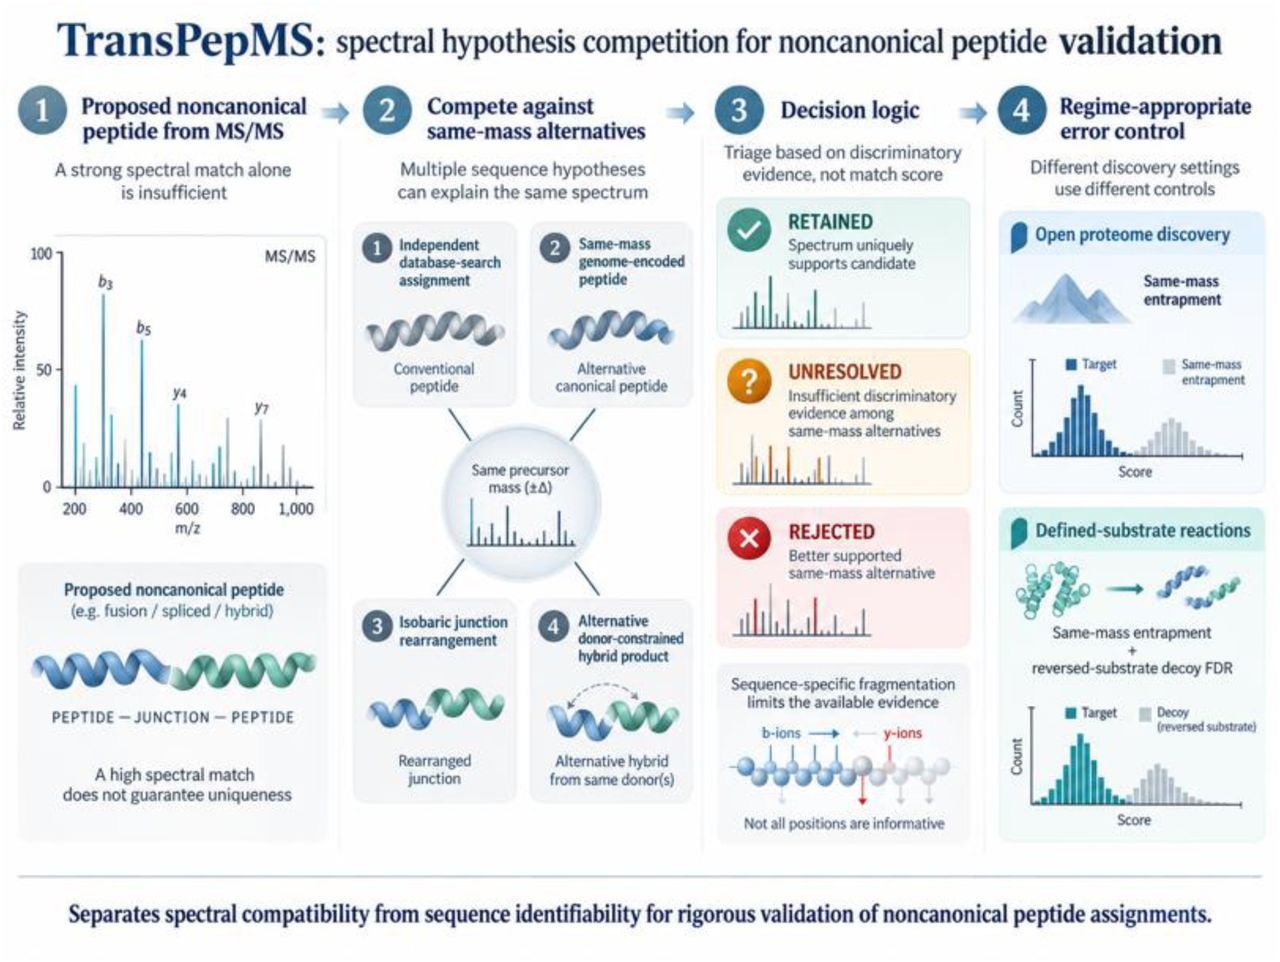
三不是随手定的。作者构造 518,400 对模拟同质量肽,在真序列已知的前提下统计错误候选被保留的频率:一个离子的余量下假保留 1,862 次,频率 3.6×10⁻³;两个离子降到 27 次;三个离子时五十一万次比对一次也没有,单侧 95% 置信上界 5.8×10⁻⁶。代价落在覆盖率上,正确候选只有 36.5% 被保留,63.5% 归入未决。这把尺子宁可说不知道,也不肯说错。
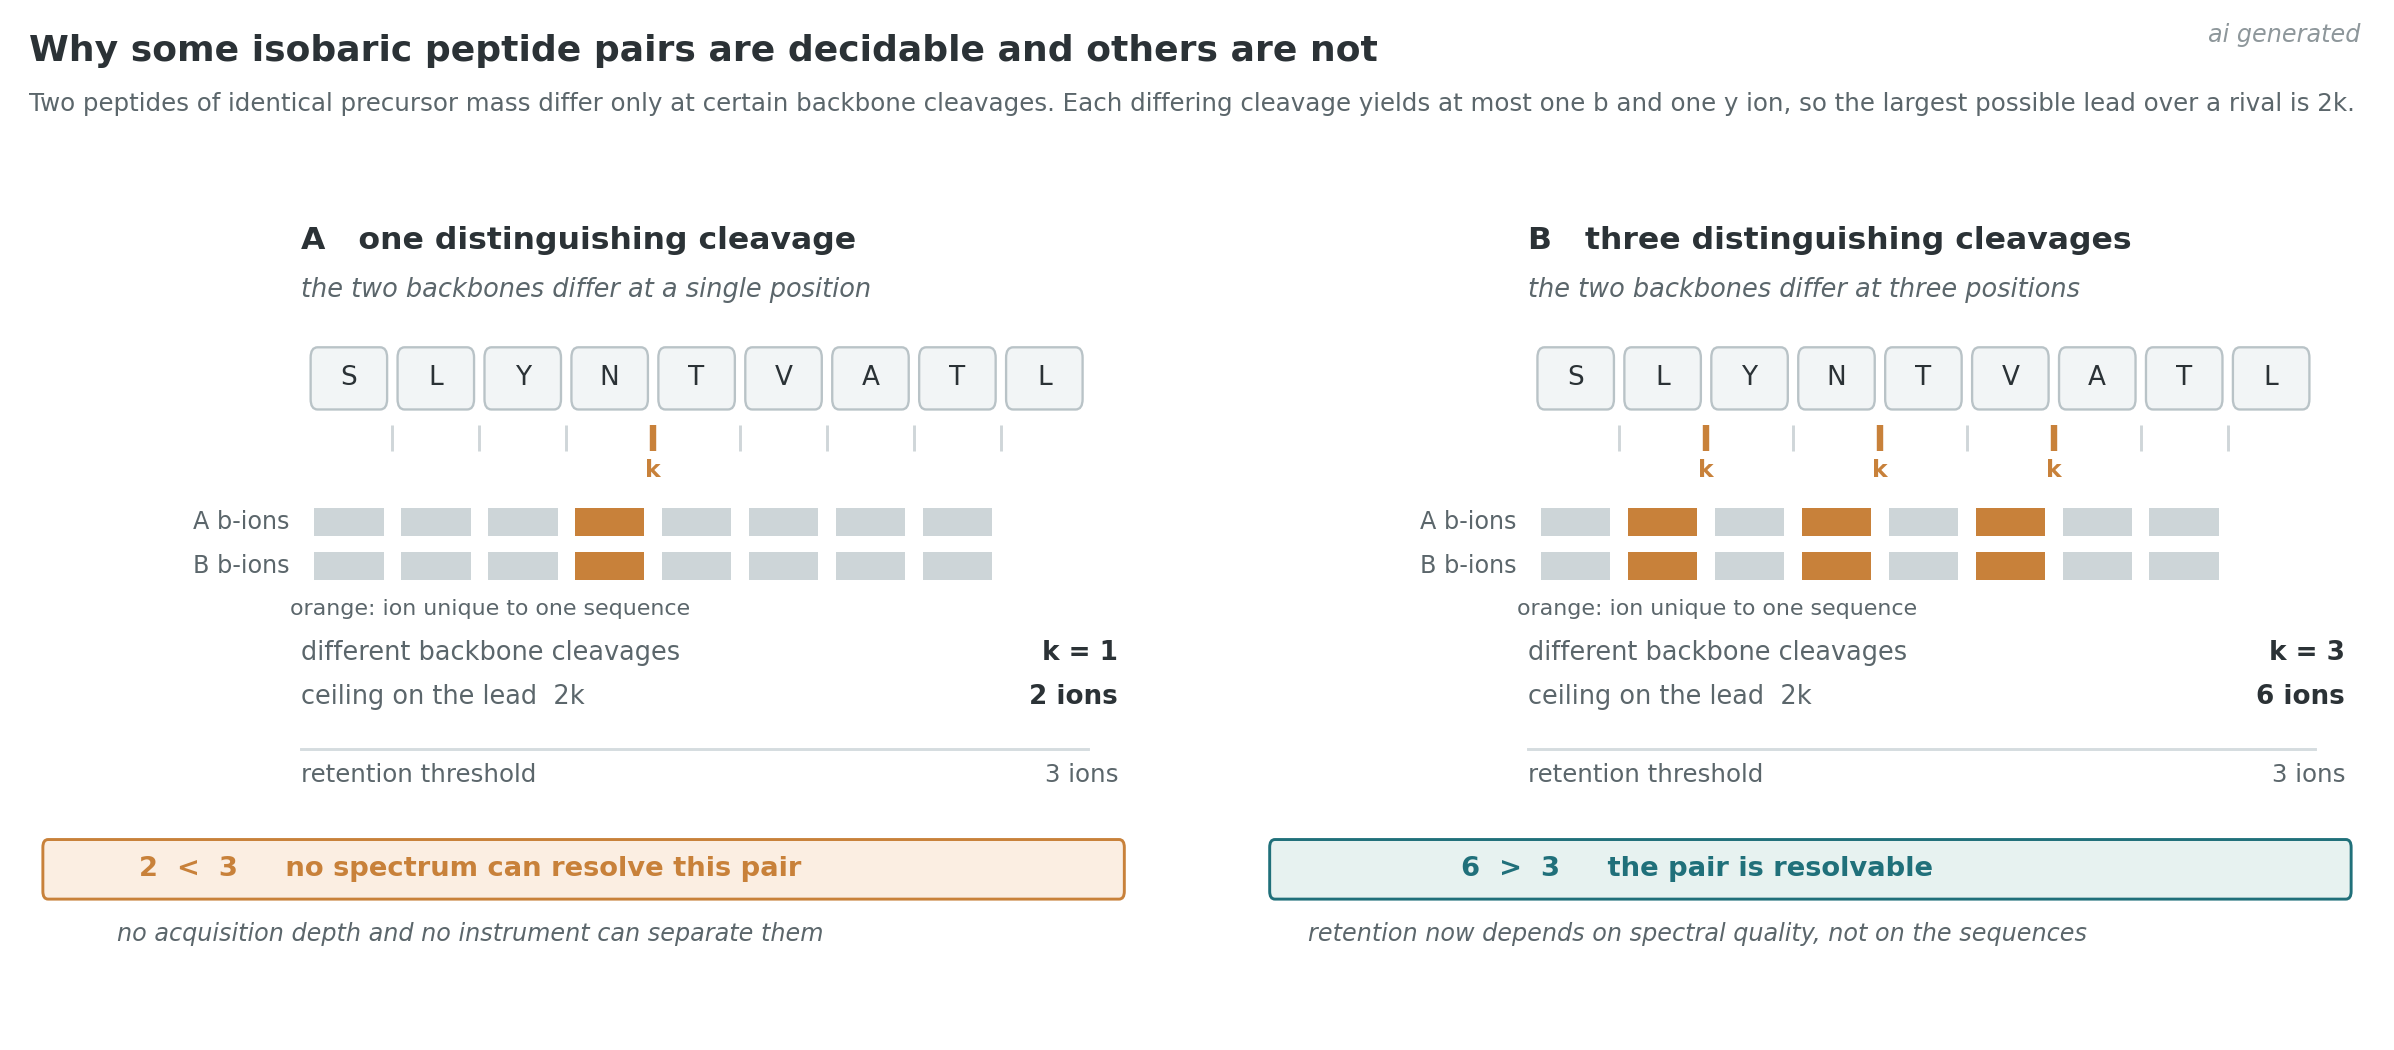
更值得琢磨的是未决意味着什么。一种可能是谱图采到的离子太少,另一种是这对序列本身太像,任何仪器都分辨不出来。作者把后者变成可预先计算的量:两条候选一经确定,它们之间不同的骨架断裂位点数 k 就定了,每个位点最多贡献一个 b 与一个 y 离子,故真序列的领先上限是 2k。k 等于一时上限只有二,永远够不到三的门槛。在 iBench 那套用合成底物与 20S 蛋白酶体做出、真序列完全已知的数据里,k=1 的 222 对无一保留,k=3 的 430 对保留 37.9%,k≥10 的 260 对保留 88.8%[9]。保留率主要不是谱图质量的问题,而是序列构造的问题。
有了这把尺子,作者回头量了三批已发表的东西。
第一批是争议最大的剪接肽目录。1,154 条被报告为蛋白酶体剪接产物的 HLA-I 配体只留下 53 条,占 4.6%;383 条被判给某条基因组编码肽,718 条未决。作为对照,同一数据集 3,603 条可信常规鉴定中 94.5% 握有正的余量,而被报告的剪接序列只有 21.2% 能做到。这批指派在谱图层面的证据分布,与真实存在的肽根本不是一回事。
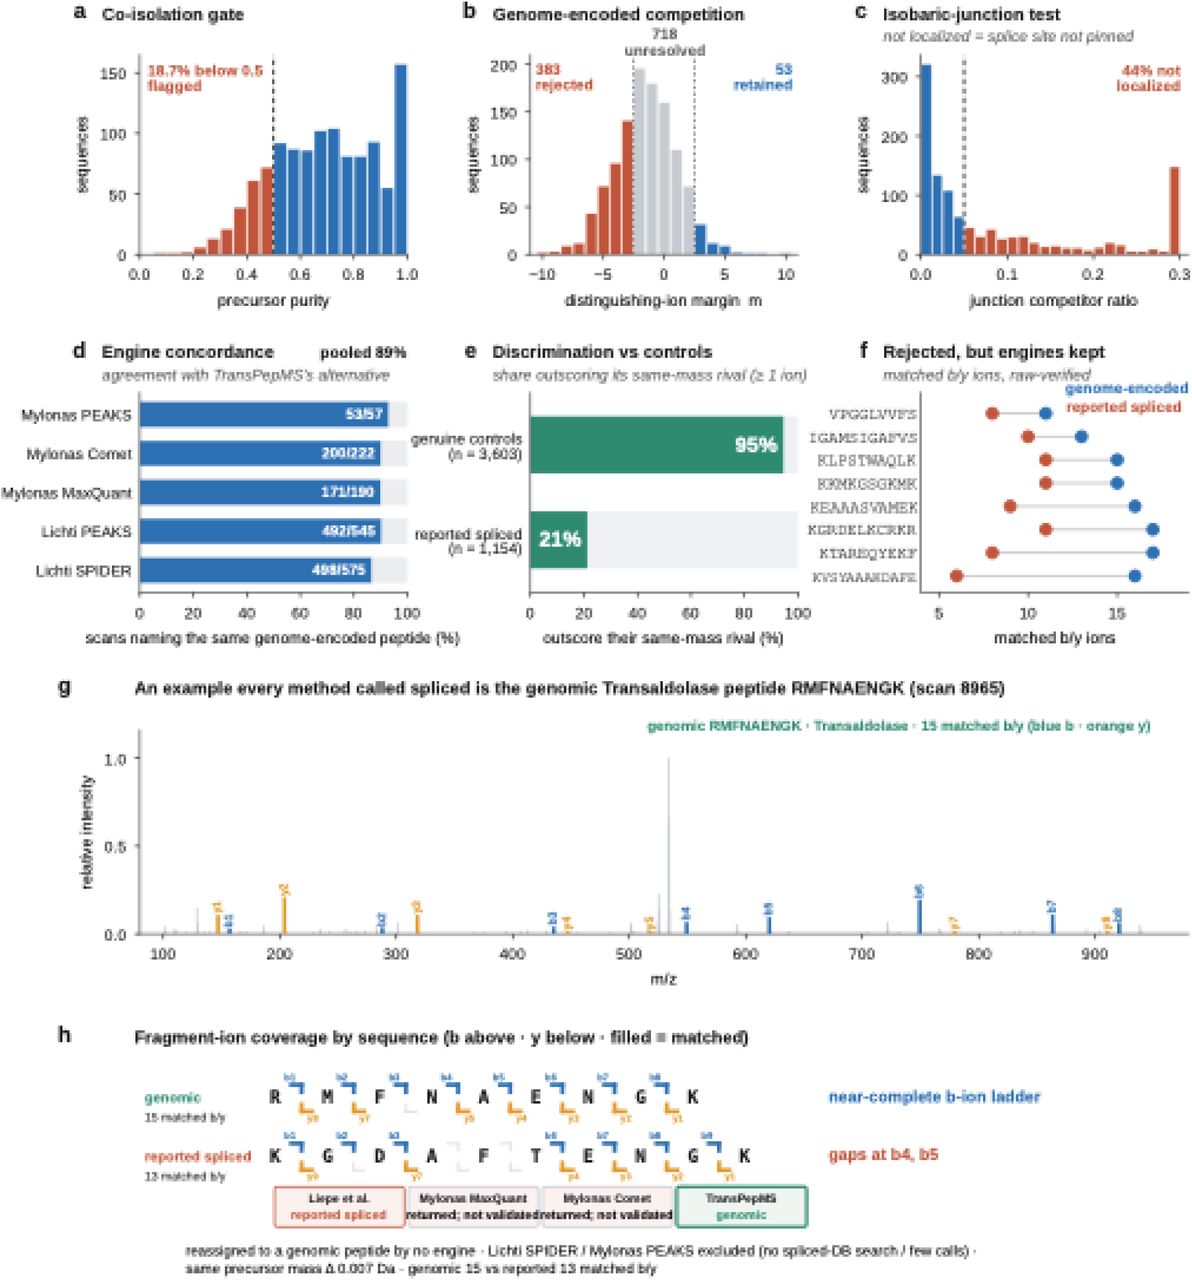
与 PepQuery2 的比较更尖锐。这个领域最常用的单谱验证工具把候选同参考蛋白组的最佳匹配及随机序列作比较[10][11],在 1,154 条里它判为 confident 的 200 条,TransPepMS 只保留 33 条、拒绝 33 条,其余未决。一个例子能说明分歧的性质:剪接序列 GPPGSVILY 被判可信,但同质量的基因组编码肽 ILGPPGSVY(来自泛素结合酶UBE2E1/2/3)多出四个 b/y 离子,恰好解释了强度最高的 y6 与 y7,而剪接序列在结构上产生不了这两个峰。这不是灵敏度之争,是两个问题的差别:PepQuery 问它是否优于参考蛋白组的最佳匹配,TransPepMS 问它是否优于所有同质量的构造,后者在原理上不可能由前者回答。
第二批是融合新抗原。一套儿童白血病 HLA-I 免疫肽组里,文献报告的六条 ETV6–RUNX1 或 CBFB–MYH11 接点肽全部检出[12],同质量竞争后只剩三条保留,十一条谱图未决,两条被拒绝,接点定位成功五条。失败的那条 MPIGRIADA 接点落在第七与第八位之间,能跨接点的 b8 与 y1 都不在谱图里,剩下六个匹配离子为报告序列与其位置重排所共享,七十二个同质量重排里十一个吻合程度相同。没有诊断离子,这条肽就只是一个可能。
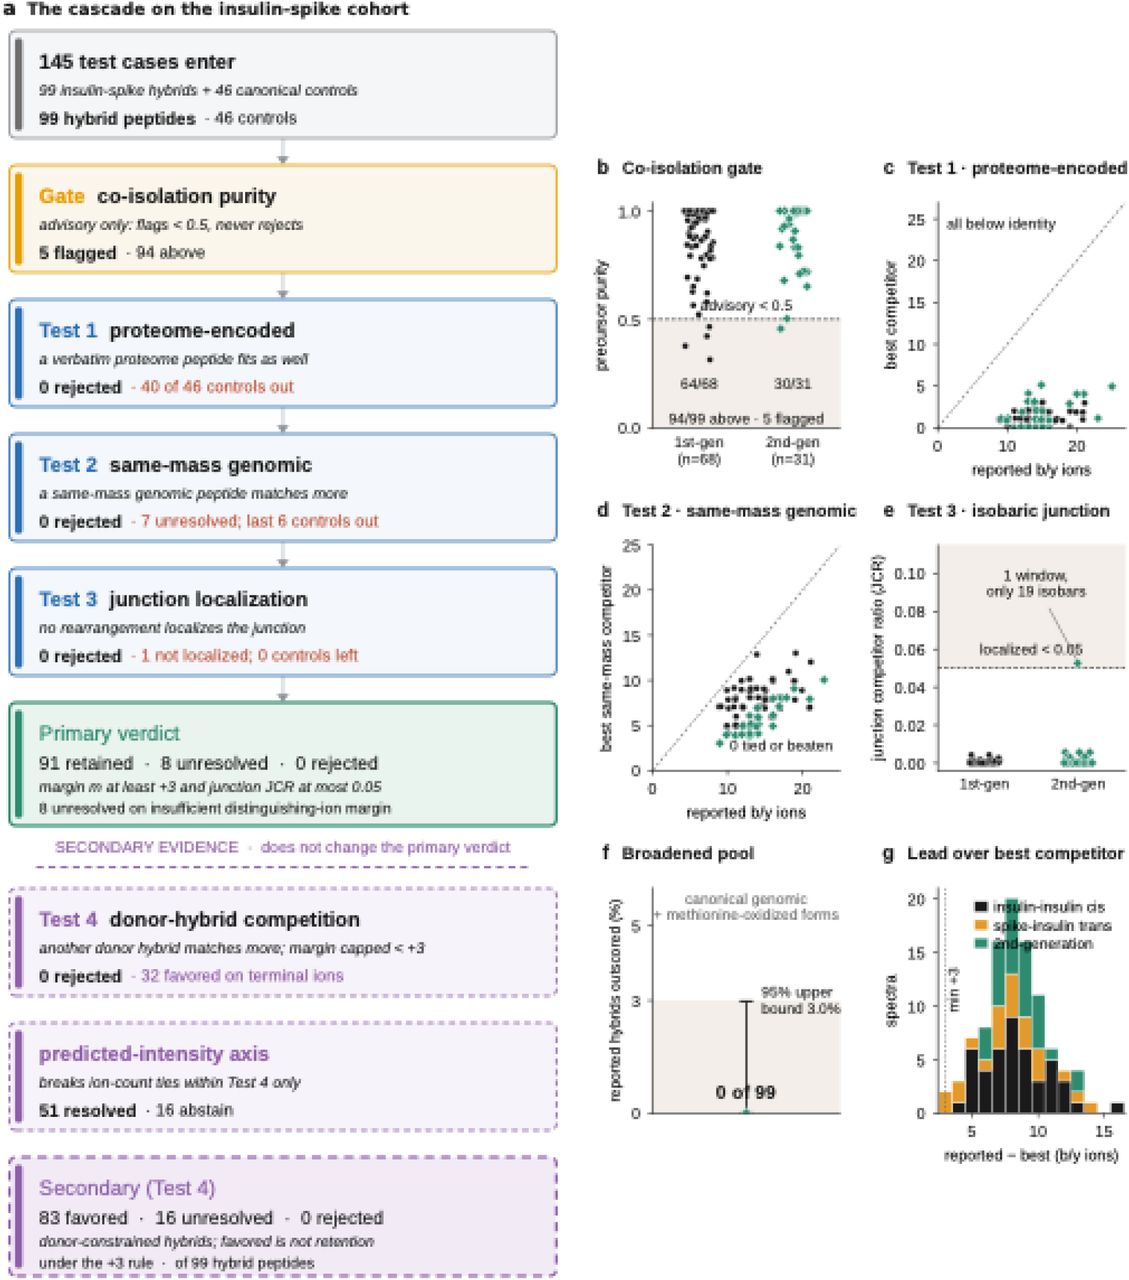
第三批是作者自己最熟悉的体系。145 条测试序列中 99 条是报告的胰岛素–刺突杂合肽,46 条是故意混进去的常规基因组编码肽,充当植入的假杂合体。结果 91 条杂合肽保留、8 条未决、0 条拒绝,46 条植入对照无一漏网,40 条被第一层竞争识破,6 条被第二层比了下去。这把尺子不是一味否决,它否掉的是能被普通肽解释的,留下的是确实握有独有离子的。
误差控制上作者做了两件事,并明确说不能混为一谈。一是同质量诱捕,拿可信谱图人为构造一条同质量但确定错误的序列,看它有多少次被误判为保留;争议数据集 3,592 个诱饵只漏 1 个,0.028%,而同一流程对真序列的保留率是 70.4%。二是反向底物诱饵,只适用于底物已知的体系,估计把 de novo 序列映射回某种底物分解方式这一步的错误率,在此为 0.5%。前者度量谱图层面的误接受,后者度量序列到蛋白的映射错误,分开报告这一点比很多同类工具诚实。
可推敲之处也不少。最直接的一条,工具的判断完全继承输入的候选集与谱图质量,它不搜库也不重新打分,retained 的准确含义是在这套证据模型下胜出,而非序列为真。作者自己在讨论里写明了这一点。
第二条是判据偏窄。判定只数 b/y 端离子,不含内离子,不纳入强度与保留时间,也不区分亮氨酸与异亮氨酸。而 HLA-I 配体多为八到十一肽,可断裂的骨架位点本就少,k 很容易落在 1 到 2 之间,恰好到不了三离子余量。这解释了剪接肽目录里六成以上未决:相当一部分不是证据不足,而是九肽这个长度给不出足够证据。对工具诚实,对使用者却是一个必须预先知道的边界。
第三条是修饰枚举的完备性直接决定结论。谷氨酰胺脱酰胺与谷氨酸同质量、N 端丝氨酸乙酰化与 N 端谷氨酸同质量,按此重判有四条应从保留改为拒绝;再补上焦谷氨酸与甲硫氨酸氧化,又有两条被决断性推翻、十一条转为未决,才落到 53 条。这个数字对考虑哪些修饰高度敏感,修饰越复杂,同质量空间越大,任何有限枚举都只是下界。
第四条是结论的读法。53/1,154 容易被引用成剪接肽基本不存在,但同一篇文章里胰岛素–刺突杂合肽 91/99 通过,融合接点肽也有三条站住。作者的结论其实是收敛的:现象真实存在,只是此前目录的规模被高估,且被高估的方式可预测,凡与常规肽共享绝大部分骨架断裂位点的构造,注定拿不到诊断离子。需要改的不是要不要相信剪接肽,而是报告方式。
对本领域的含义有两层。流程上,非经典肽的清单进入下游前应先过一遍同质量竞争,就像当年 target-decoy 成为标配。文献读法上,过去几年以非经典为卖点的清单不少,其中相当一部分是纯计算的重新挖掘,谱图证据从未被单独审查。笔者评述过的髓母细胞瘤非经典配体组与 Ewing 肉瘤暗蛋白组都属此类,候选并非不成立,但在被当作发现引用之前,值得用这把尺子量一遍。
回到开头的问题:一张谱图能容下几条肽。答案往往是不止一条。质谱给出的从来不是序列,而是序列与谱图之间的一致性;把一致性误认为唯一性,是这个领域最古老也最昂贵的错误。TransPepMS 的价值不在否掉了多少条肽,而在把不可判定从一句托词变成一个可以提前算出来的数:k 等于一,就不必再指望更高的采集深度;k 等于三,才值得花钱合成标准品。承认某些谱图永远给不出答案,比给出一个漂亮却站不住的序列要难,也有用得多。
参考文献
- Liepe J, Marino F, Sidney J, et al. A large fraction of HLA class I ligands are proteasome-generated spliced peptides. Science. 2016;354(6310):354-358. DOI: 10.1126/science.aaf4384
- Admon A. Are there indeed spliced peptides in the immunopeptidome? Mol Cell Proteomics. 2021;20:100099. DOI: 10.1016/j.mcpro.2021.100099
- Mylonas R, Beer I, Iseli C, et al. Estimating the contribution of proteasomal spliced peptides to the HLA-I ligandome. Mol Cell Proteomics. 2018;17(12):2347-2357. DOI: 10.1074/mcp.RA118.000877
- Lichti CF. Identification of spliced peptides in pancreatic islets uncovers errors leading to false assignments. Proteomics. 2021;21(7-8):e2000176. DOI: 10.1002/pmic.202000176
- Faridi P, Li C, Ramarathinam SH, et al. A subset of HLA-I peptides are not genomically templated: evidence for cis- and trans-spliced peptide ligands. Sci Immunol. 2018;3(28):eaar3947. DOI: 10.1126/sciimmunol.aar3947
- Tabatabaei Dakhili SY, Hinse O, Foster LJ, Brömme D. TransPepMS: a tool to verify peptides absent from reference proteomes. bioRxiv. 2026. DOI: 10.64898/2026.10.20.760571
- Hinse O, Tabatabaei Dakhili SY, Freiburger L, et al. Cathepsin K mediates the formation of potential rheumatoid arthritis-relevant cis- and trans-spliced peptides compatible with HLA-DR4 presentation. bioRxiv. 2026. DOI: 10.64898/2026.09.06.749279
- Reed B, Crawford F, Hill RC, et al. Lysosomal cathepsin creates chimeric epitopes for diabetogenic CD4 T cells via transpeptidation. J Exp Med. 2021;218(2):e20192135. DOI: 10.1084/jem.20192135
- Cormican JA, Soh WT, Mishto M, Liepe J. iBench: a ground truth approach for advanced validation of mass spectrometry identification method. Proteomics. 2023;23(1-2):e2200271. DOI: 10.1002/pmic.202200271
- Wen B, Wang X, Zhang B. PepQuery enables fast, accurate, and convenient proteomic validation of novel genomic alterations. Genome Res. 2019;29(3):485-493. DOI: 10.1101/gr.235028.118
- Wen B, Zhang B. PepQuery2 democratizes public MS proteomics data for rapid peptide searching. Nat Commun. 2023;14:2213. DOI: 10.1038/s41467-023-37462-4
- Savoie C, et al. The GF-NEO discovery platform unveils a [KQE][DG] sequence motif within fusion neoantigens in pediatric cancer. iScience. 2026;29(2):114512. DOI: 10.1016/j.isci.2025.114512
内容经AI校正和润色,审慎阅读