原文见笔者个人网站 www.liangxiao.pro。内容经AI校正和润色,可能存在不准确之处,仅供研究参考。
把整个HLA-I序列交给一个预训练的Transformer,让注意力自己圈出哪些残基重要,再把圈出的65个残基与NetMHCpan沿用二十年的34个接触残基合并,得到一条88残基的伪序列——这是丽康生命(Likang Life Sciences)团队发表在iScience上的LKMHCpan对结合预测输入端的核心改动[1]。肽–MHC结合预测是新抗原管线的中枢:基因组和转录组给出的是候选名单,真正决定谁进入功能验证的,是打分器给每个候选肽分配的分数。而打分器的输入里,等位基因的表示方式从NetMHCpan最初的伪序列设计起就是固定约定——只取结合槽附近的34个残基[2];二十年间打分器从位置打分矩阵演进到深度学习,从NetMHCpan 4.1到加入迁移学习与结构特征的4.2[3][4],槽位本身从未被重新定义过。这一次,模型被要求自己去读结合槽。
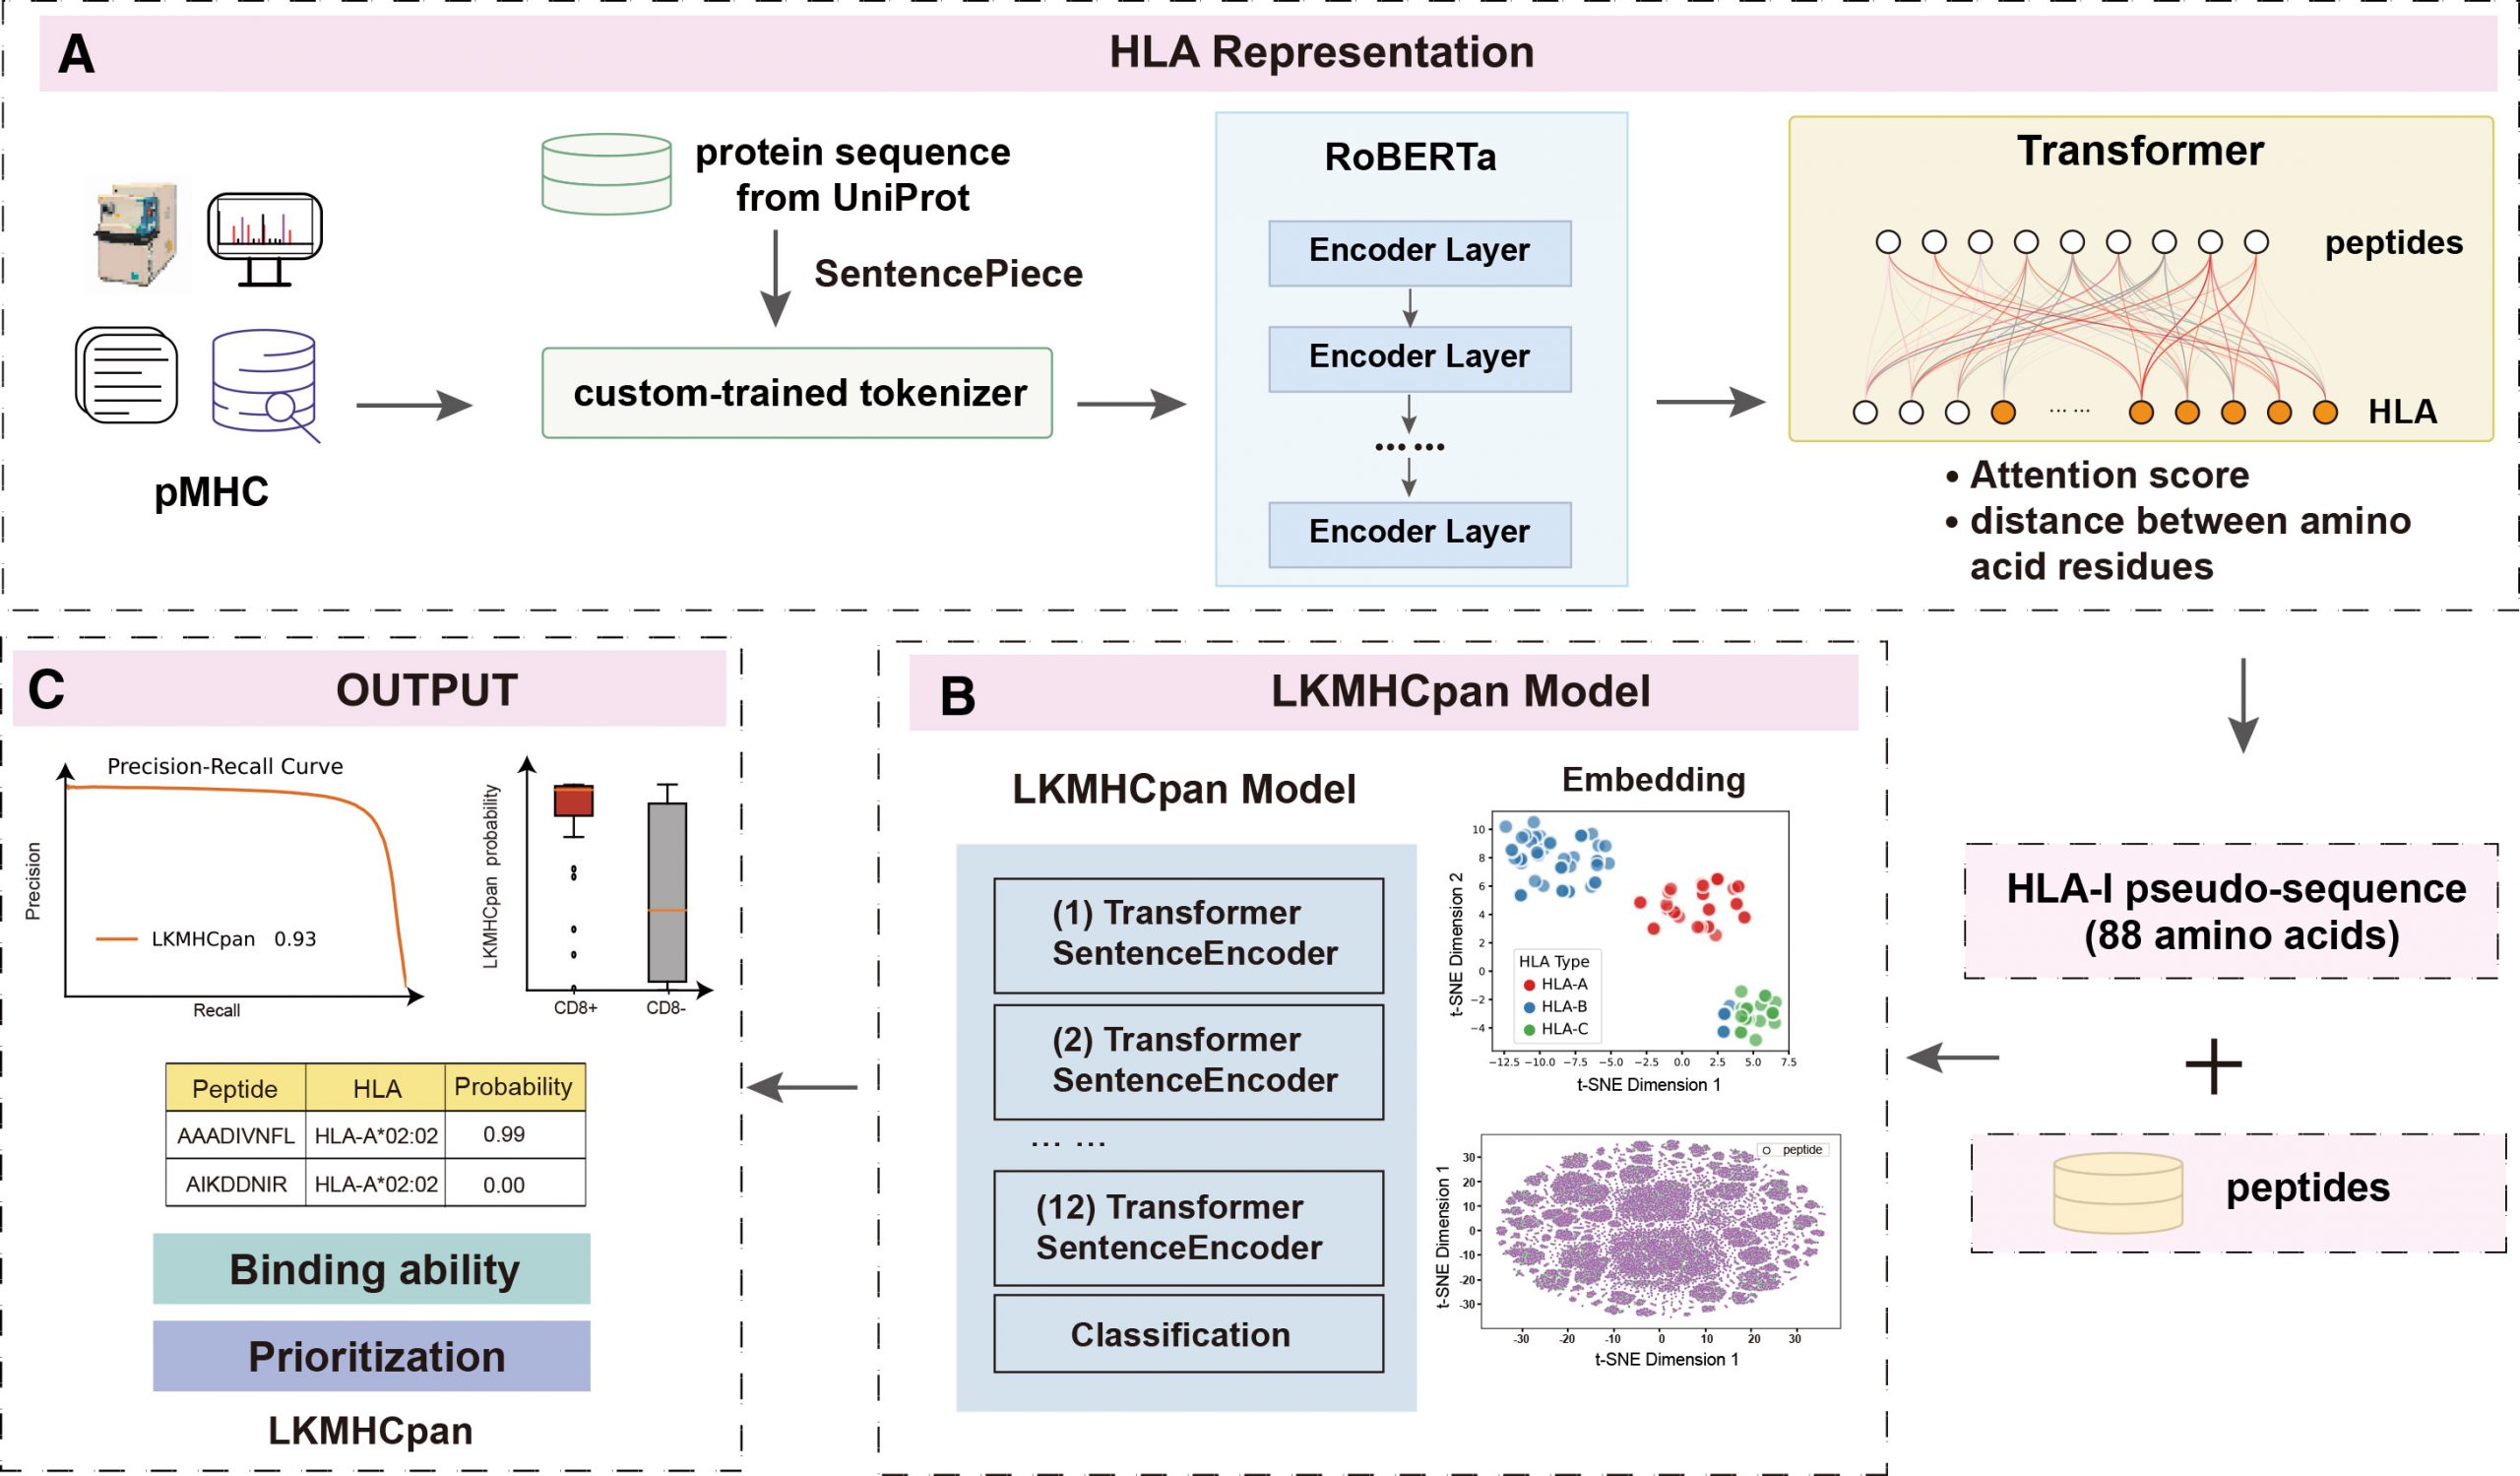
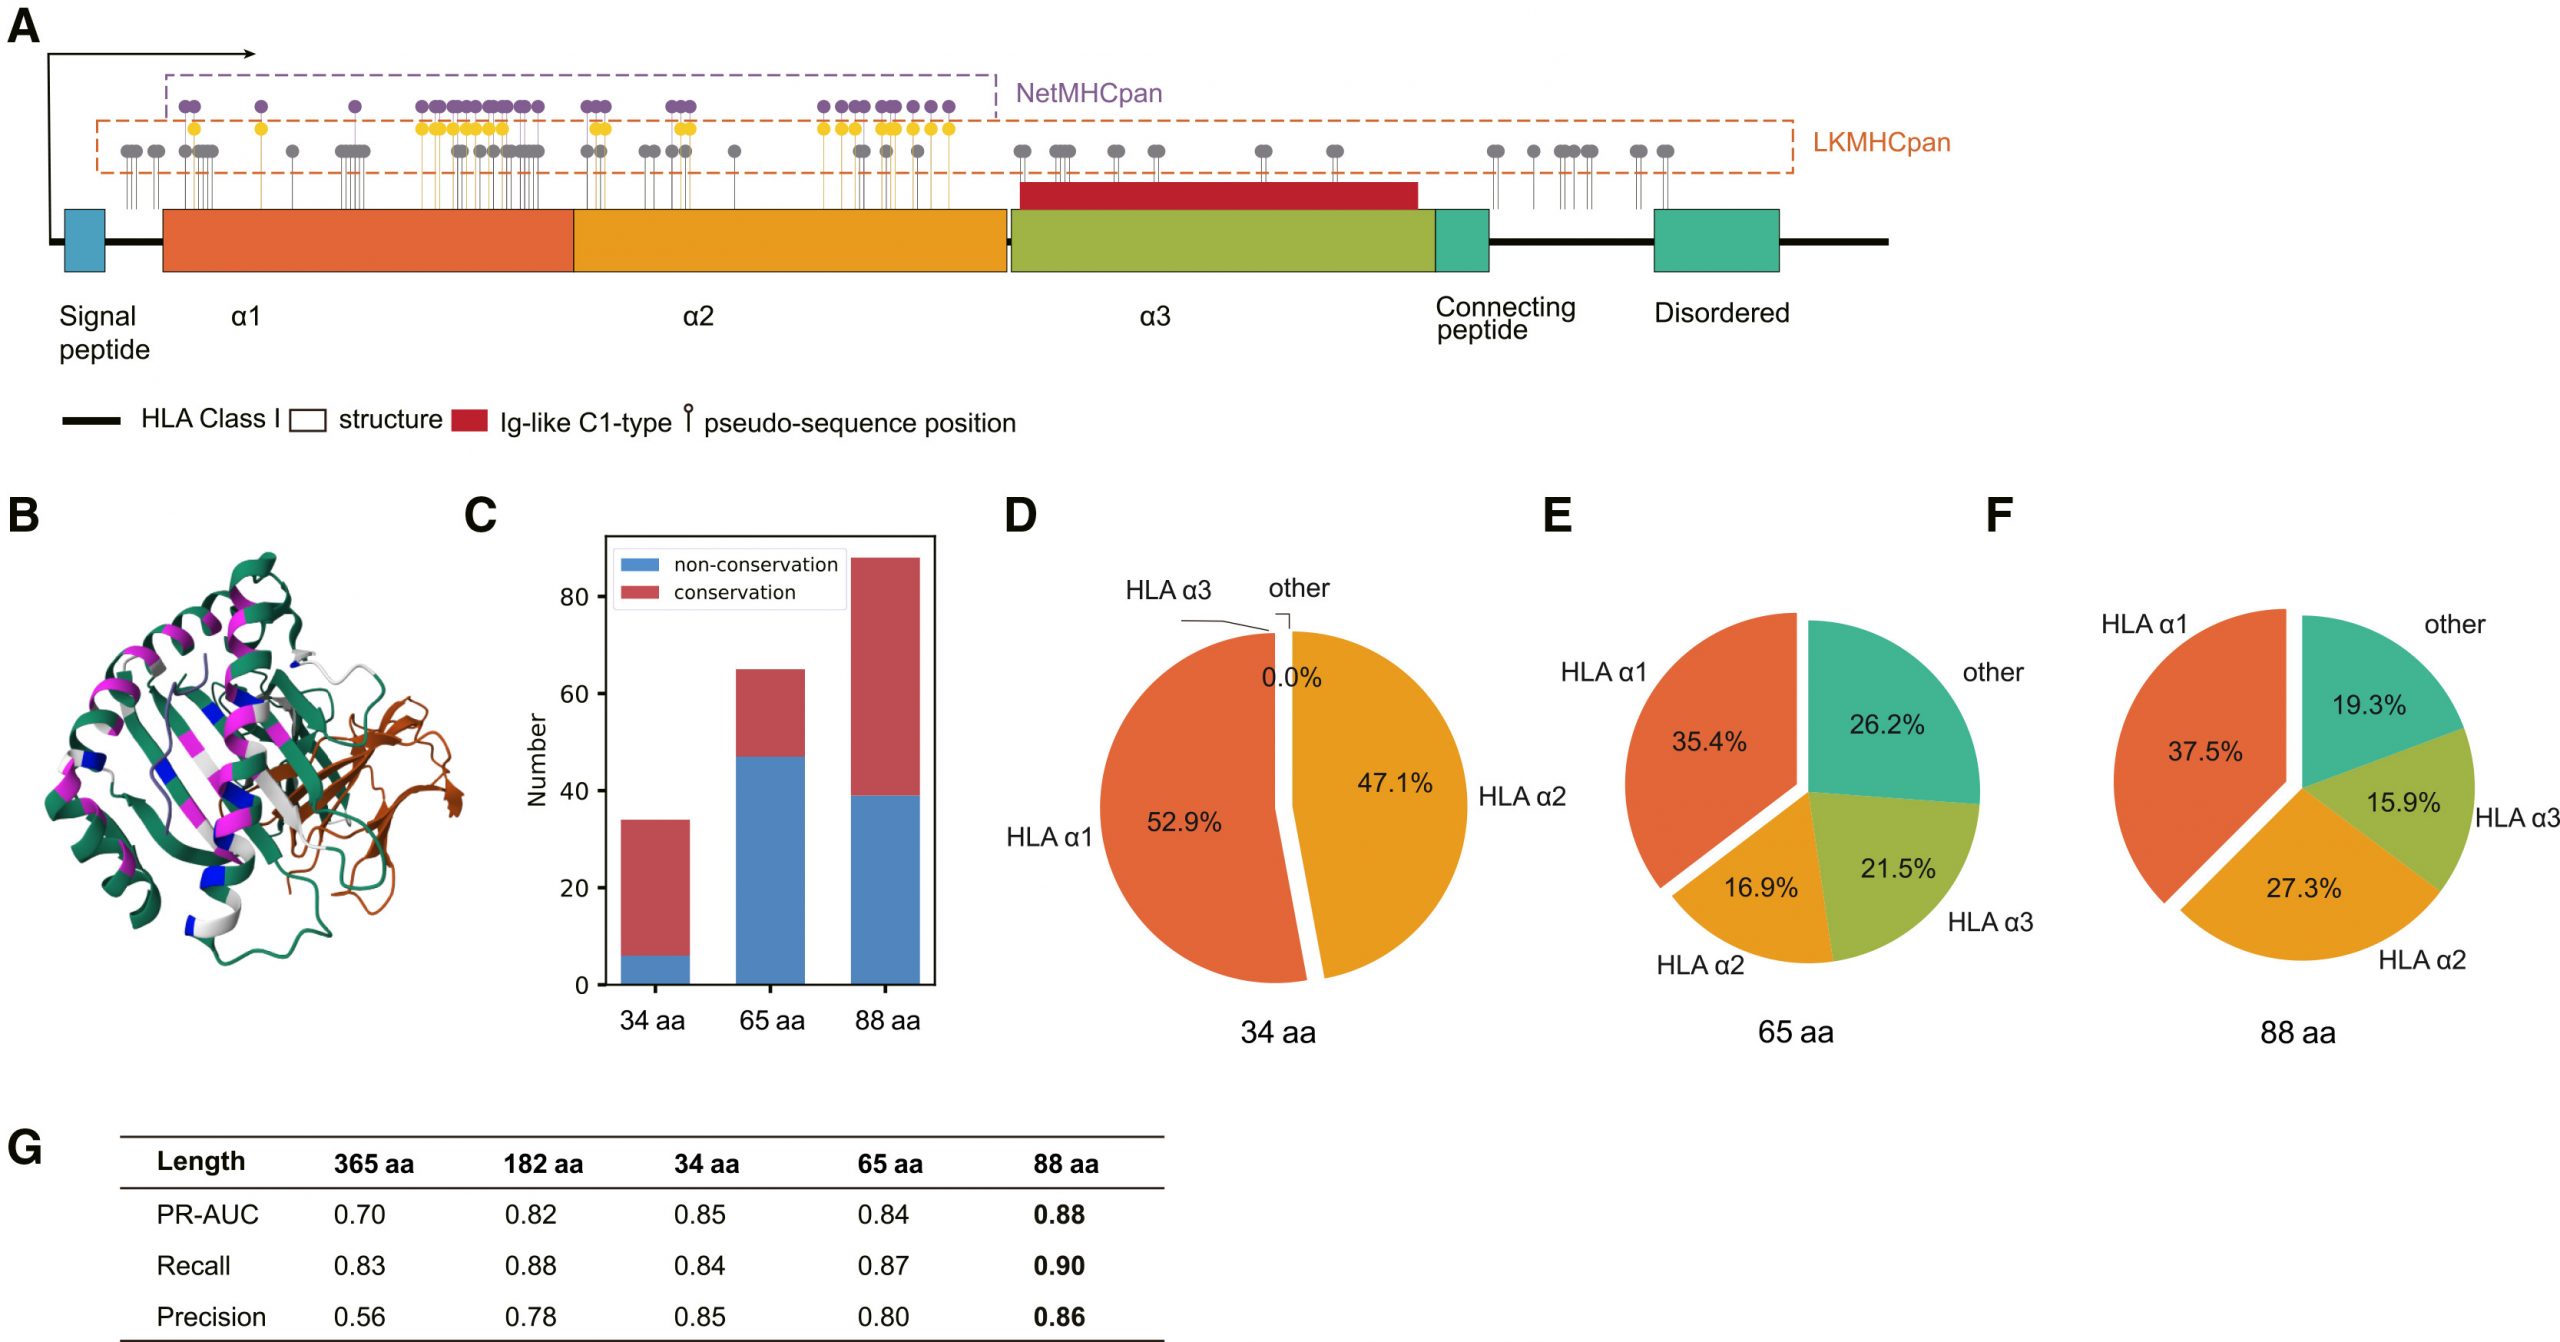
方法分三步。UniProt蛋白序列经SentencePiece分词后,先在272万条肽序列上以掩码语言建模预训练一个12层的RoBERTa编码器;再把肽与HLA配对做微调,从所有层、所有注意力头的平均权重里挑出65个高注意力残基;最后以肽加88残基伪序列为输入训练二分类器,训练集覆盖119个等位基因上50.2万条实验验证的结合正样本,负样本由正样本随机打乱生成。圈定的65个残基与NetMHCpan的34个肽接触残基重叠11个,超几何检验p=0.013,两条独立路线方向上彼此印证;这些残基的保守性显著低于HLA-I序列整体(OR=12.19),说明注意力圈定的正是多态性富集的功能位点。它们不止落在α1、α2,还深入α3结构域——α3参与肽呈递并非凭空设想,W6/32泛HLA抗体的结构解析已给出直接证据[5]。在同一架构内比较五种表示方式,88残基版本在PR-AUC、召回与精确率上同时占优[1]。
| HLA-I表示方式 | 全长365残基 | α1+α2共182 | NetMHCpan 34残基 | 注意力65残基 | 合并88残基 |
|---|---|---|---|---|---|
| PR-AUC | 0.70 | 0.82 | 0.85 | 0.84 | 0.88 |
| 召回率 | 0.83 | 0.88 | 0.84 | 0.87 | 0.90 |
| 精确率 | 0.56 | 0.78 | 0.85 | 0.80 | 0.86 |
榜单数字上,LKMHCpan在NetMHCpan 4.1的评估集上平均PR-AUC达到0.93、AUC0.1为0.97,同台的NetMHCpan、MixMHCpred与MHCflurry均不超过0.87[1][6][7];与最新的NetMHCpan 4.2相比,各肽长下的PR-AUC也更高[4]。真正拉开差距的是长肽:12–14mer的PR-AUC超过0.78,而这条长度带正是免疫肽组学里非经典呈递越来越常被检出的区间。泛化方面,四个从未参与训练的等位基因PR-AUC为0.90,其中作者自测的HLA-B*15:18配体组(3264条肽)单独给出0.91;HLA-B*27的C67S单残基突变体导致锚定残基向P1漂移,这一基序变化被模型正确读出,而且是在两个竞品把第67位残基手工改成S以作公平比较的前提下胜出[1]。免疫肽组学层面的独立检验用的是25个单等位基因细胞系的大规模配体组(4.4万条肽)[8],预测结果与实测呈递的对齐构成方法学的质控底座。
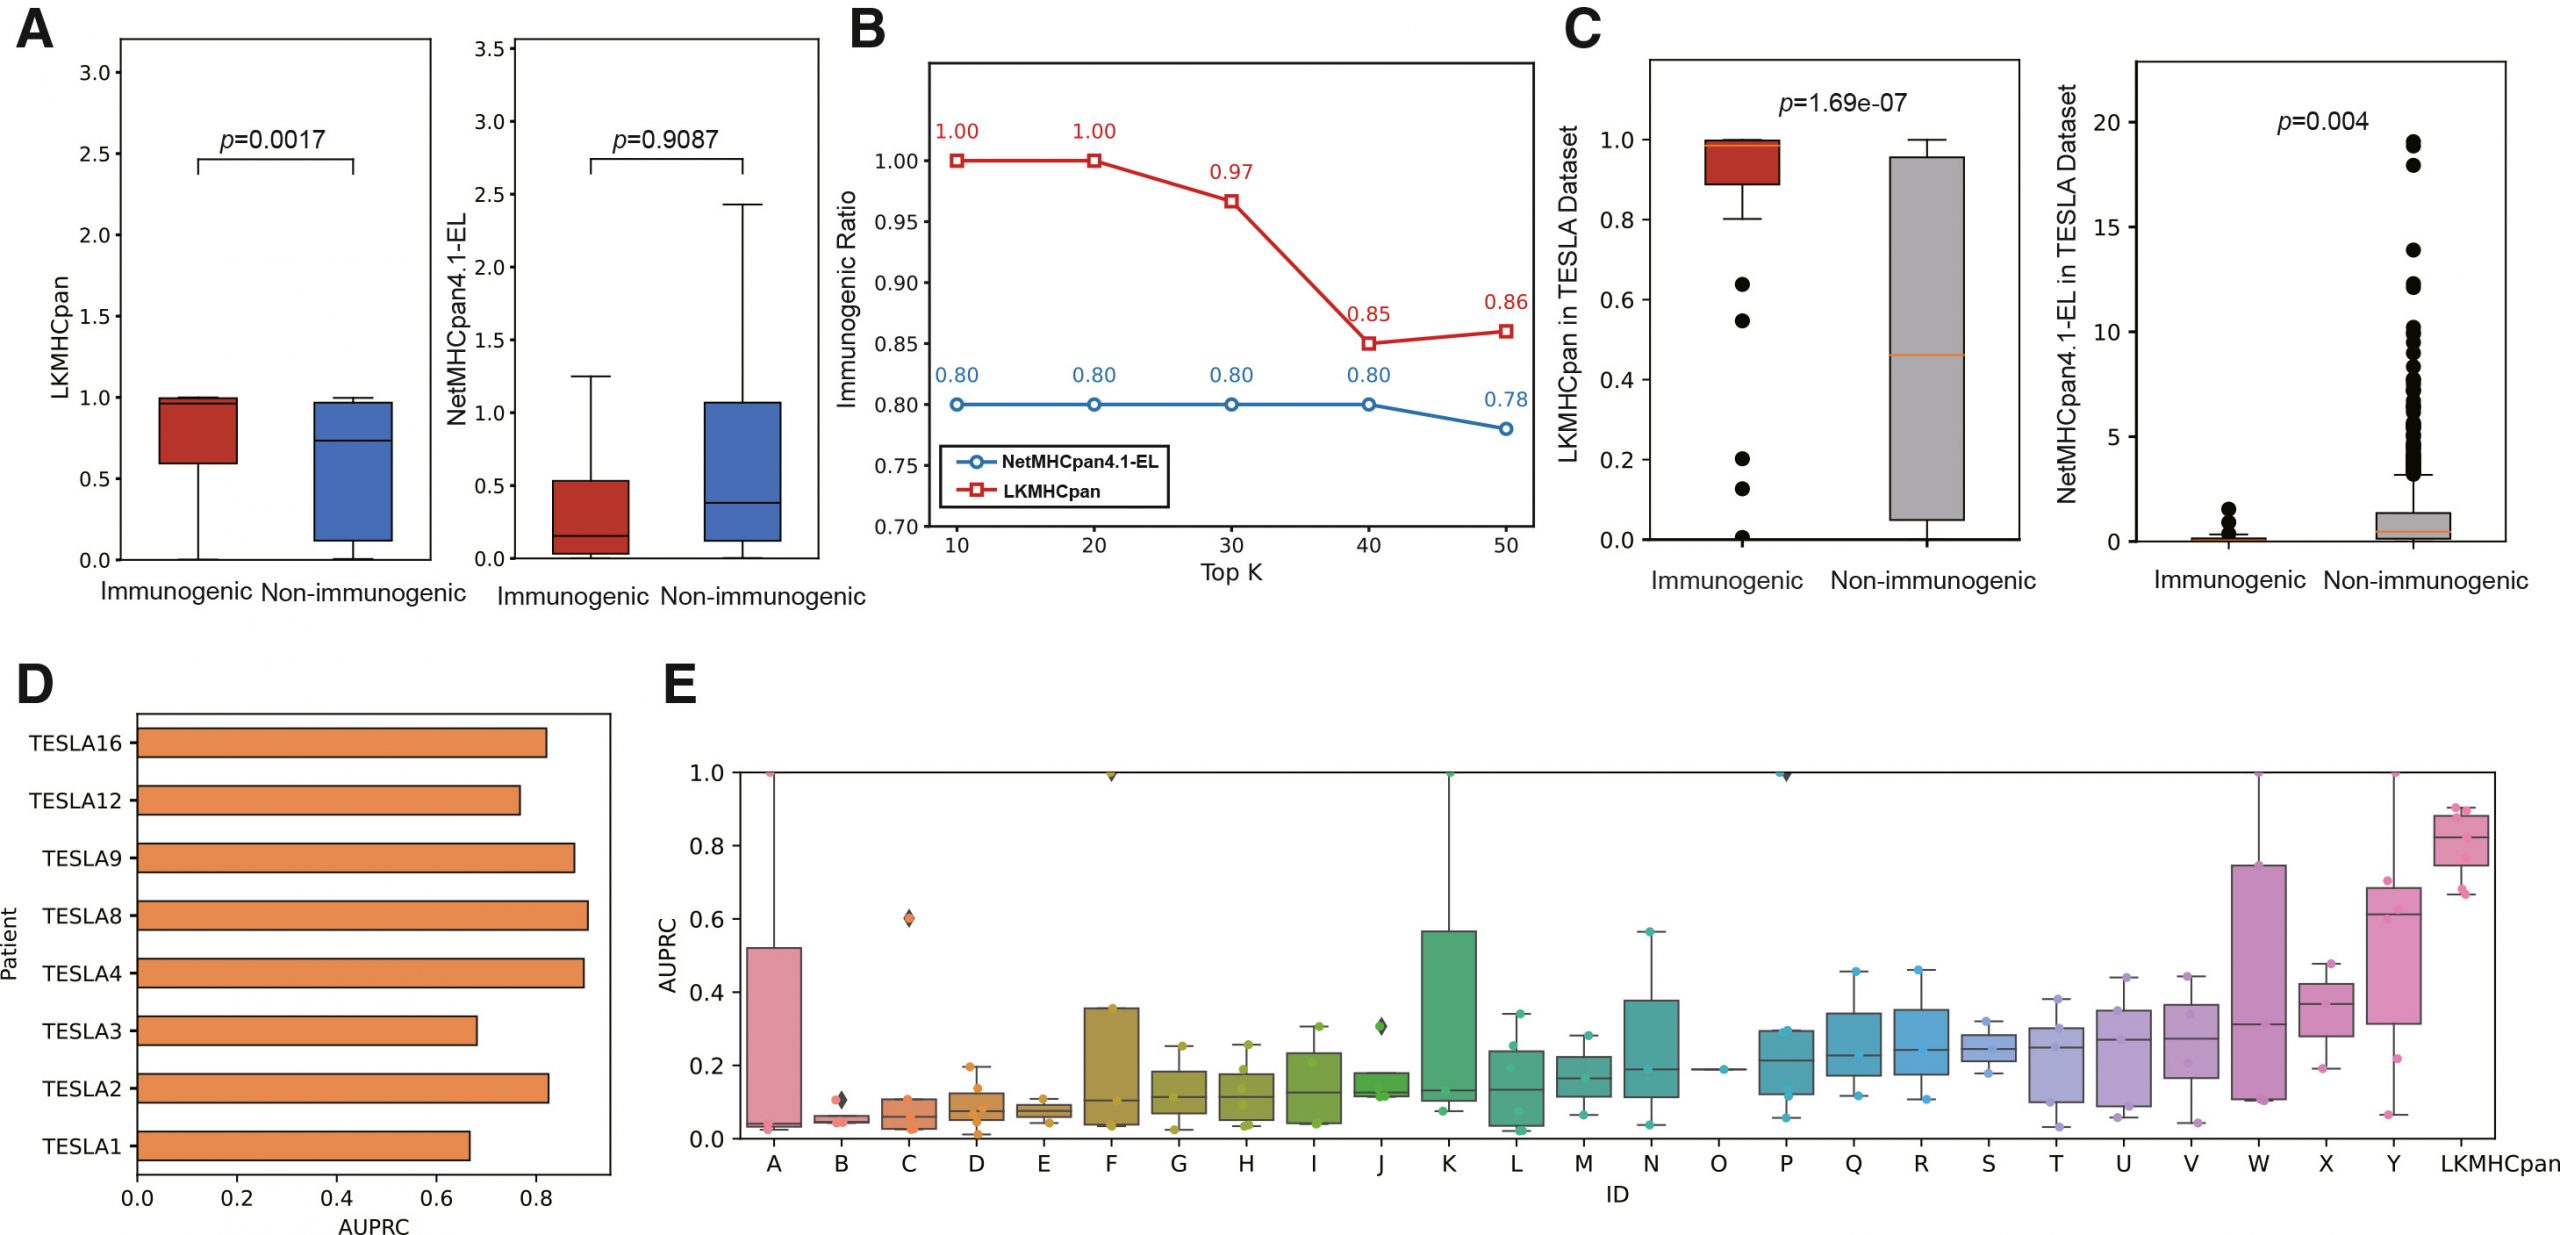
结合预测只是工具,判断的落点是免疫原性。TESLA联盟8名患者的736条肽中,LKMHCpan区分免疫原与非免疫原肽的p值达到1.69e-07,NetMHCpan-EL为0.004[9];每患者AUPRC均值0.80(范围0.67–0.90),top-50排序可覆盖94%的验证免疫原性肽,整体优于TESLA当年25家团队的大部分提交。两条临床队列的相关性分析给出同一方向:73例黑色素瘤TIL治疗患者中,应答者的预测新抗原负荷686对非应答者的225(p=0.004),ROC曲线下面积0.76[10];309例肺癌免疫检查点阻断队列中,预测负荷与应答和总生存均相关,低负荷组相对高负荷组的死亡风险比为1.52(95%CI 1.11–2.08)[11]。
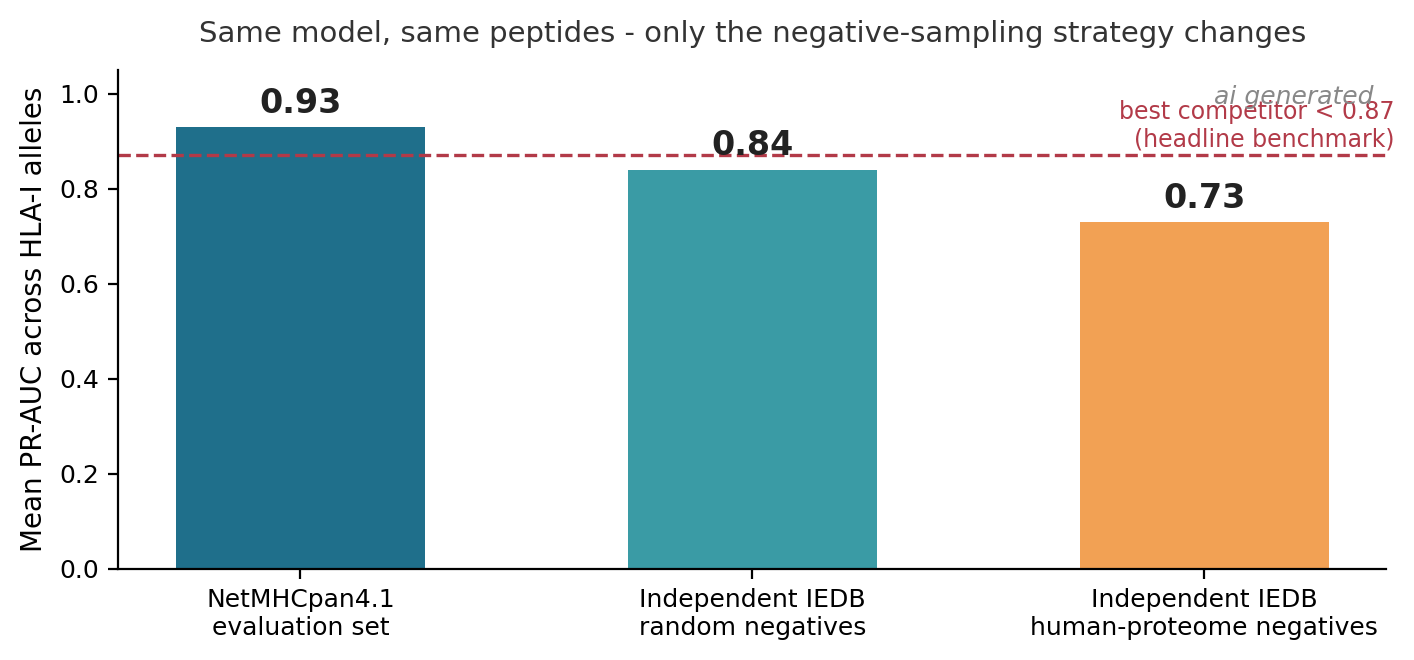
这些数字的口径值得盯住。0.93来自NetMHCpan 4.1的评估集,而LKMHCpan自己的独立IEDB测试显示,负样本从全随机换成人类蛋白组采样,PR-AUC从0.84掉到0.73[1]。随机打乱会把天然短基序破坏掉,使负样本过于好认,作者在局限性一节承认这可能夸大精度。这正是过去一年pMHC基准讨论的核心:BenchMHC的预印本提醒过,训练集与评估集之间的序列同源泄漏足以让工具的表观成绩脱离真实难度[12]——LKMHCpan的预训练语料同样取自IEDB,评估集纵使做了去重,语料层面的记忆效应仍难以彻底排除。0.93与0.73之间隔着二十个PR-AUC点,标题口径与最严口径的差距,比任何两家竞品之间的差距都大。
公司背景需要一句说明。论文的通讯作者与多数作者是丽康生命员工,资助方即公司,属于典型的企业自研论文;但代码与模型在GitHub与Zenodo开源,免疫肽组学原始数据存入PRIDE(PXD064665),透明度在同类公司论文里算是做得较足的。“88残基优于34残基”的结论在模型架构同时改变的情况下归因并不能完全干净,好在作者把表示策略的对比放在同一架构内做了(上表),这一步是关键控制。此外,预测负荷与肿瘤突变负荷强相关,其在TMB之外的独立贡献需要更大队列确认,作者把这一点写进了局限;稀有等位基因几乎没有实验数据可用,这是整个社区的共同欠账,作者呼吁扩充。伪序列是一个自2007年被NetMHCpan固化以来沿用至今的工程约定[2],二十年来迭代的是打分器而不是槽位本身;让模型从注意力里重新读出结合槽、再用结构生物学交叉验证,这个思路比榜单名次更有回味。对新抗原管线而言,打分器每一次翻新都会直接改写提名名单——谁的口径诚实,比谁的数字漂亮更值得长期跟踪。
- Li Q, Liu S, Yao M, Chen H, Yu Y, Zhang B, Jia M, Chen L. LKMHCpan: Transformer-optimized HLA-I pseudo-sequences enhance neoantigen prediction for immunotherapy. iScience 2026;29:118134. https://doi.org/10.1016/j.isci.2026.118134
- Nielsen M, Lundegaard C, Blicher T, Lamberth K, Harndahl M, Justesen S, et al. NetMHCpan, a method for quantitative predictions of peptide binding to any HLA-A and -B locus protein of known sequence. PLoS ONE 2007;2:e796. https://doi.org/10.1371/journal.pone.0000796
- Reynisson B, Alvarez B, Paul S, Peters B, Nielsen M. NetMHCpan-4.1 and NetMHCIIpan-4.0: improved predictions of MHC antigen presentation by concurrent motif deconvolution and integration of MS MHC eluted ligand data. Nucleic Acids Research 2020;48:W449-W454. https://doi.org/10.1093/nar/gkaa379
- Nilsson JB, Greenbaum J, Peters B, Nielsen M. NetMHCpan-4.2: improved prediction of CD8+ epitopes by use of transfer learning and structural features. Frontiers in Immunology 2025;16:1616113. https://doi.org/10.3389/fimmu.2025.1616113
- Pymm P, Hayhurst J, Hayman J, Bujawa A, Al-Attar H, Clement CS, et al. The structural basis for recognition of human leukocyte antigen class I molecules by the pan-HLA antibody W6/32. The Journal of Immunology 2024;213:876-885. https://doi.org/10.4049/jimmunol.2400328
- Gfeller D, Schmidt J, Croce G, Guillaume P, Bobisse S, Genolet R, et al. Improved predictions of antigen presentation and TCR recognition with MixMHCpred2.2 and PRIME2.0 reveal potent SARS-CoV-2 CD8+ T-cell epitopes. Cell Systems 2023;14:72-83.e5. https://doi.org/10.1016/j.cels.2022.12.002
- O’Donnell TJ, Rubinsteyn A, Laserson U. MHCflurry 2.0: improved pan-allele prediction of MHC class I-presented peptides by incorporating antigen processing. Cell Systems 2020;11:42-48.e7. https://doi.org/10.1016/j.cels.2020.06.010
- Pyke RM, Heft H, Konduri R, Melton A, Rubinstein Y, Chu C, et al. Precision neoantigen discovery using large-scale immunopeptidomes and composite modeling of MHC peptide presentation. Molecular & Cellular Proteomics 2023;22:100506. https://doi.org/10.1016/j.mcpro.2023.100506
- Wells DK, van Buuren MM, Ang KK, Stegen S, Masson G, Riteau N, et al. Key parameters of tumor epitope immunogenicity revealed through a consortium approach improve neoantigen prediction. Cell 2020;183:818-834.e13. https://doi.org/10.1016/j.cell.2020.09.015
- Levi ST, Copeland AR, Nah S, Crystal JS, Ivey GD, Lalani A, et al. Neoantigen identification and response to adoptive cell transfer in anti-PD-1 naïve and experienced patients with metastatic melanoma. Clinical Cancer Research 2022;28:3042-3052. https://doi.org/10.1158/1078-0432.CCR-21-4499
- Ravi A, Hellmann MD, Arniella MB, Holton M, Freeman SS, Naranbhai V, et al. Genomic and transcriptomic analysis of checkpoint blockade response in advanced non-small cell lung cancer. Nature Genetics 2023;55:807-819. https://doi.org/10.1038/s41588-023-01355-5
- Borck T, Chabrol M, Colombo D, Imbert A, Perier-Dulhoste M, Volzhenin K, et al. BenchMHC: a reproducible framework for peptide-MHC presentation prediction. bioRxiv 2026.10.22.760998. https://doi.org/10.64898/2026.10.22.760998
内容经AI校正和润色,审慎阅读