原文见笔者个人网站 www.liangxiao.pro。内容经AI校正和润色,可能存在不准确之处,仅供研究参考。
10月22日,MIT的Bryan Bryson与Forest White实验室(Ragon研究所与Koch研究所)在bioRxiv上线了一篇论文[1],用一套靶向质谱流程把免疫肽组学里一个心照不宣的假设摆上了台面:能结合MHC的肽,和真正被感染细胞呈递的肽,中间隔着的距离可能远比预测模型假设的要远。研究的主角是结核杆菌。此前的免疫肽组学工作已经发现,感染人源巨噬细胞后,被HLA-I呈递的Mtb肽绝大多数来自七型分泌系统(T7SS)底物,这个观察让作者相信,把候选范围收窄到“会被分泌的蛋白”,再加一层MHC结合筛选,就足以逼近真实的表位空间[2]。
他们为此准备的工具是两项前作的组合。一侧是Holec等人的酵母展示平台:九肽文库与β2微球蛋白融合表达,与指定HLA等位基因的α链共表达,能稳定MHC复合物的肽在酵母表面富集,从而给出高通量的实验结合测量,还能捞到NetMHCpan这类纯计算方法漏掉的假阴性[3]。另一侧是内部标准平行反应监测(IS-PRM,即SureQuant):先探测掺入样品的同位素标记合成肽,再触发对内源肽的高分辨采集,把仪器时间集中花在目标肽洗脱的窗口上[4]。两相对接的逻辑很干净:先用酵母展示把Mtb T7SS底物与常见疫苗抗原的全九肽空间过一遍筛子,再用靶向质谱回答这些结合肽里有哪些真的出现在感染细胞的MHC-I上。
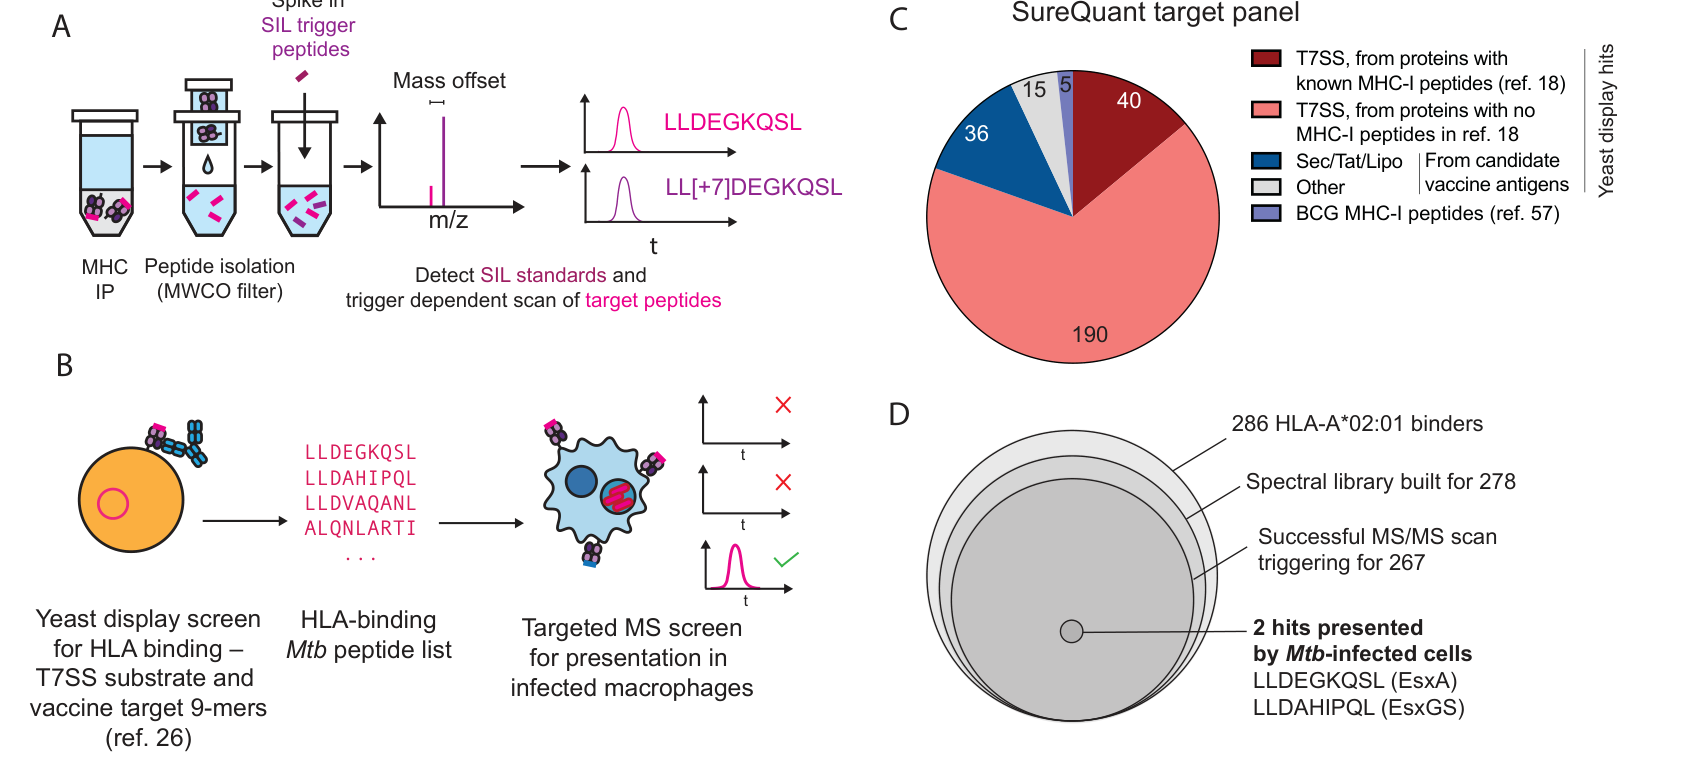
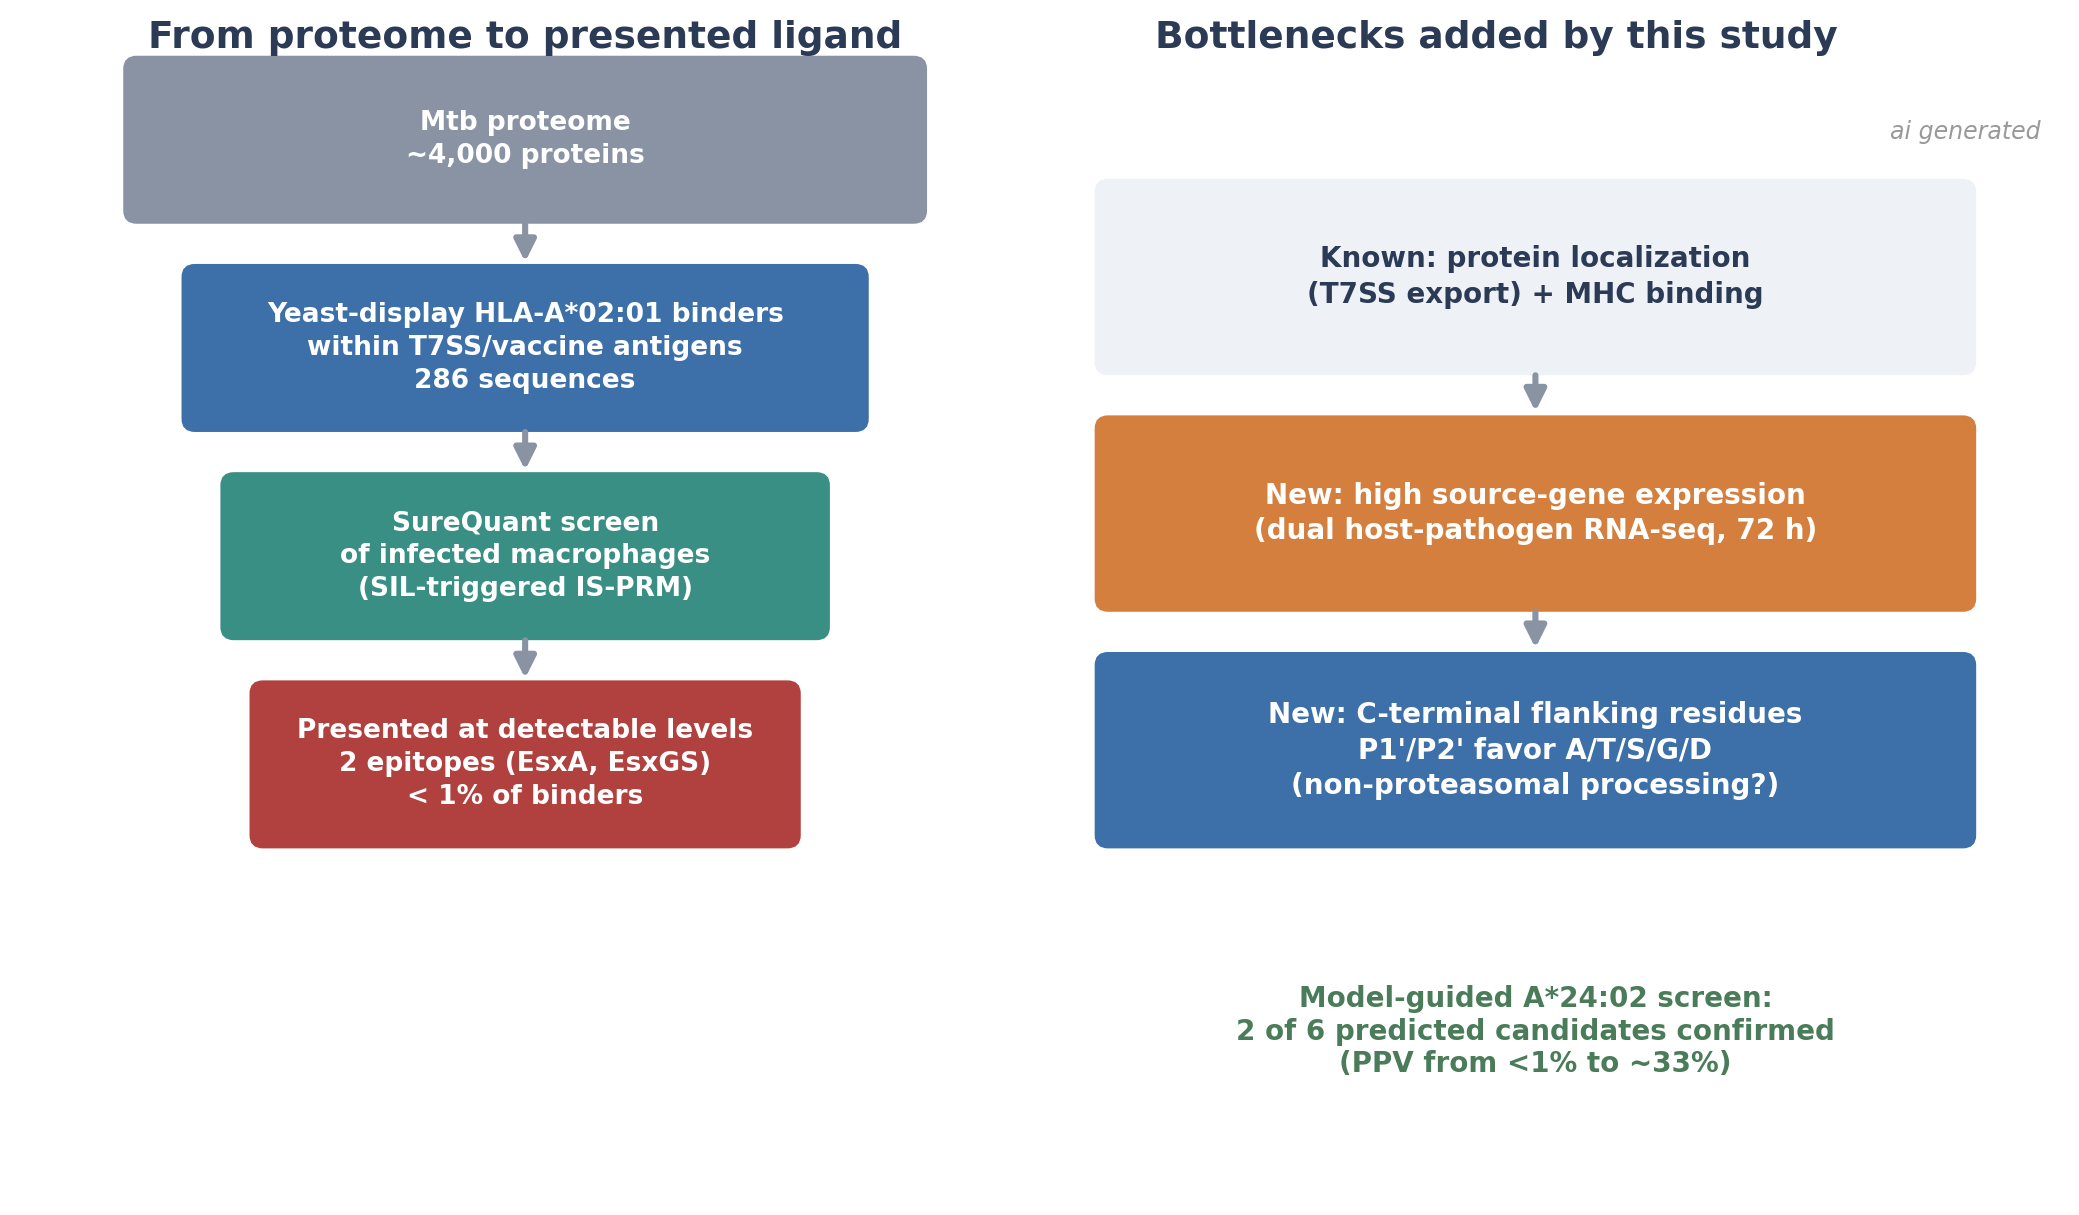
结果出乎作者自己的预料。以HLA-A*02:01为对象,面板由286条酵母展示结合肽加上50条此前用非靶向质谱看到过的自肽对照构成。在两百万个感染巨噬细胞的输入量下,只检出一条Mtb肽,EsxA的LLDEGKQSL,恰好是前作非靶向分析里见过的老面孔;而50条自肽对照检出了44条,在HLA不匹配的Raji细胞里全部阴性,说明管线本身工作正常。把输入量先后加码到一千万和两千五百万个细胞,Mtb肽也只多出一条EsxGS的LLDAHIPQL。更有说服力的是几组阴性对照:把文献报道过的A*02:01限制性Mtb表位汇总成453条的回查面板,除作为阳性对照的EsxA外全部落空;把面板缩到7条肽以排除循环时间限制,无新增;用重标肽-MHC复合物标定检测下限,7条肽在相当于每细胞10到100个拷贝的浓度下均可检出、其中两条低至1拷贝仍可见,而EsxA与EsxGS并不比落选者更“好测”。技术性解释被逐一排除之后,剩下的结论只有一个:定位加结合,远不足以决定呈递。
作者于是照着肿瘤免疫肽组学里HLAthena的思路搭了一个可解释的机器学习框架[5]:每个候选肽拿到三个独立分数,来自肽序列本身的结合分数、来自双侧五个侧翼残基的加工分数、来自双宿主-病原体转录组(感染后72小时、五个供体平均)的源基因表达分数。分层结果相当清楚:只用结合分数,区分已呈递肽与百倍过量的酵母展示阳性序列,AUPRC只有0.245;换用表达分数升到0.696;表达加结合达到0.918(95%置信区间0.755至1.0)。被检出的Mtb抗原几乎都是T7SS底物里表达最高的一档,但表达最高的基因里又有很多并非T7SS底物——分泌通路与高表达,两个条件缺一不可。把表达值按半log分箱以防止模型记住具体基因,结果不变;换成逻辑回归,特征层级也不变。
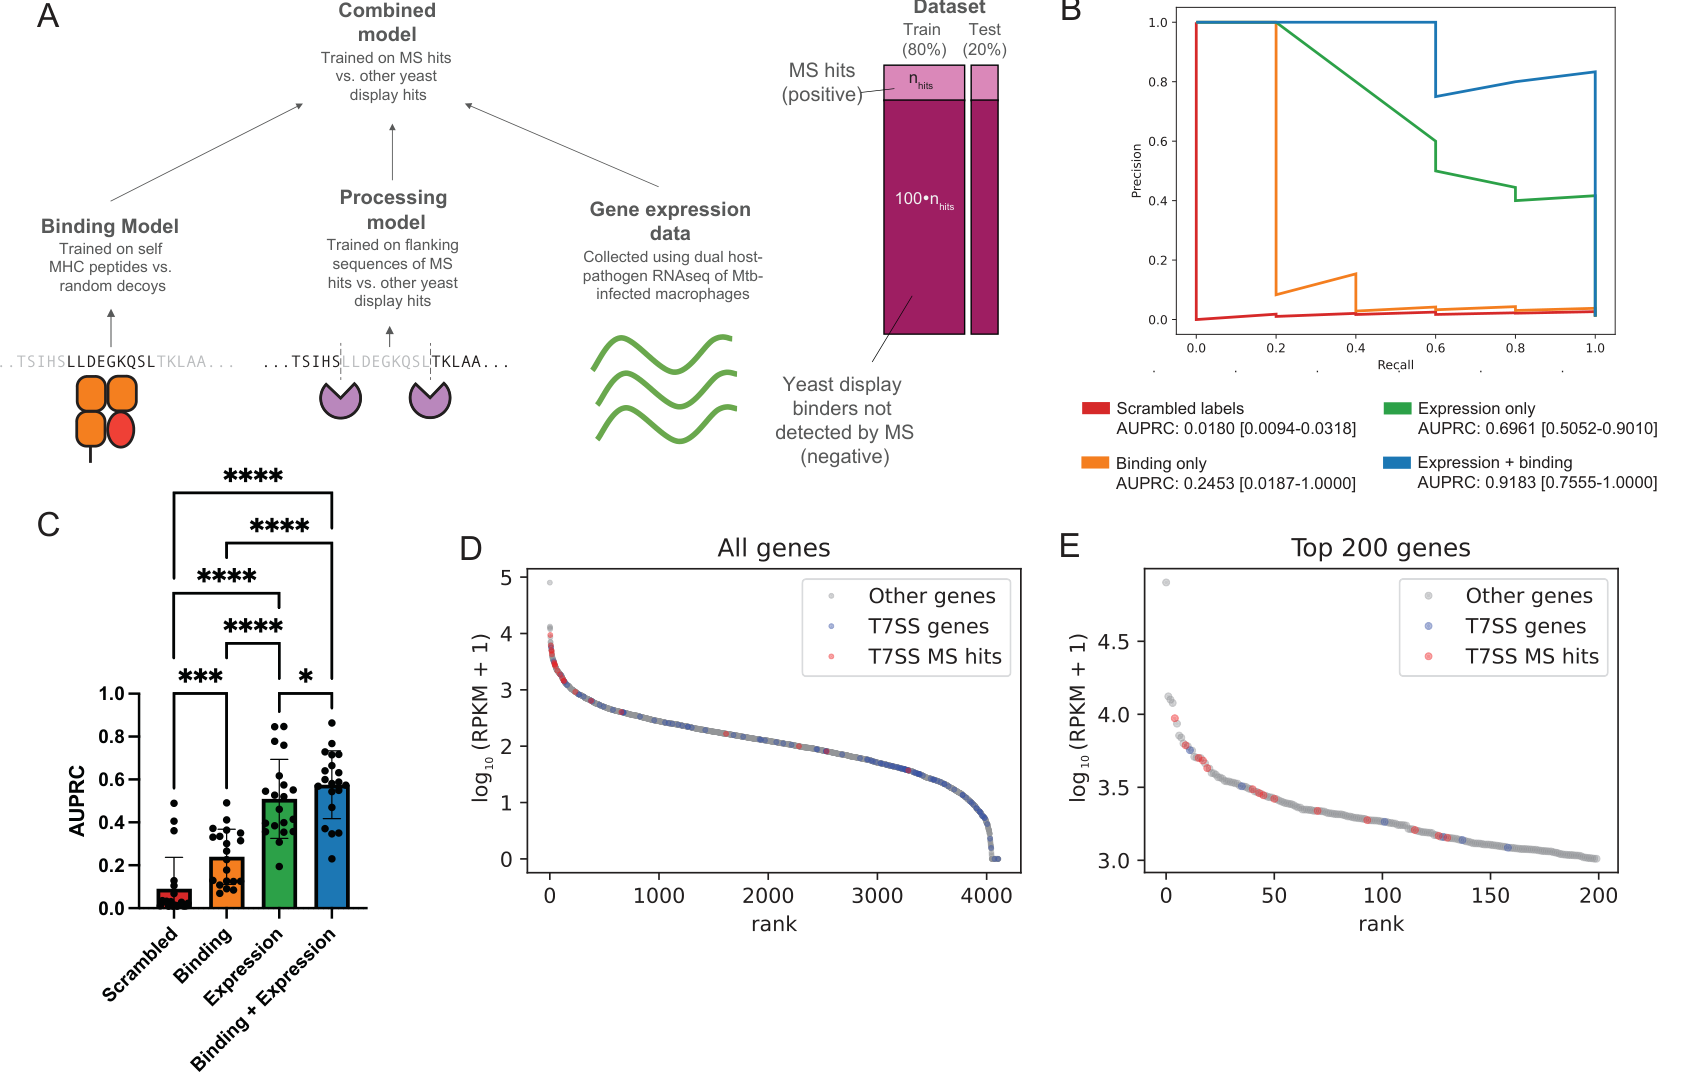
表达量解释不了同一蛋白内部的差别:EsxA里被呈递的肽与没被呈递的肽共享同一份mRNA。把所有T7SS来源MHC-I肽的C端侧翼对齐,P1’与P2’位置显著富集侧链体积小的残基——丙氨酸、苏氨酸、丝氨酸、甘氨酸、天冬氨酸;同一批数据里的自肽没有这个偏好,两者侧翼残基的分布差异显著。这个偏好与蛋白酶体的切割规律对不上,而前作已经证明药物抑制蛋白酶体或组织蛋白酶都不消除Esx家族肽的呈递,加工Mtb抗原的可能是一条身份未明的蛋白酶通路。N端侧翼没有清晰的motif,作者归因于ERAP修剪对N端的抹平。同一抗原内两个表位因加工效率不同而命运迥异,在李斯特菌里早有先例[6];在高表达抗原子集里,把加工分数加进模型确实带来增量,只是这个增量放到全数据集上就被小样本放大成噪声。
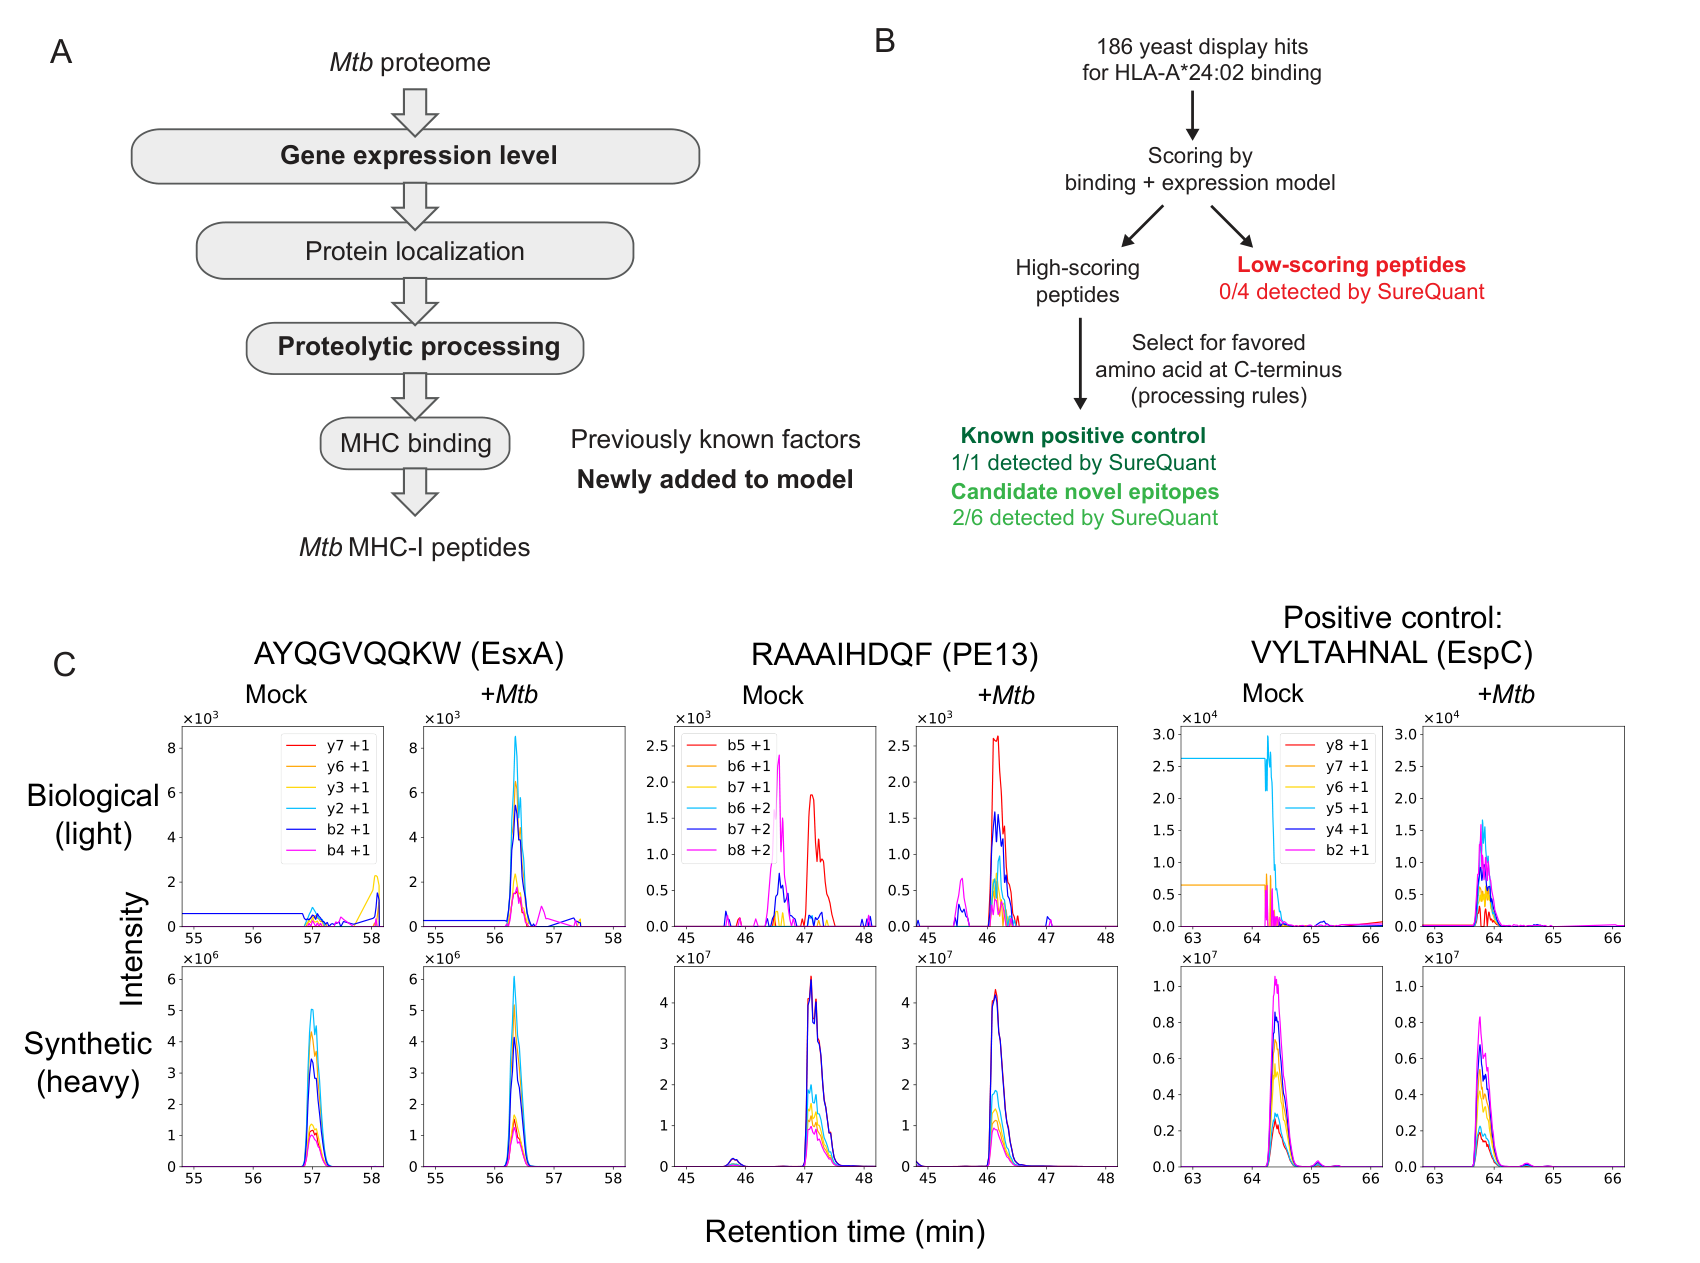
模型的成色要看前瞻检验。作者转向HLA-A*24:02:186条酵母展示结合肽先过表达加结合模型的打分,再叠加T7SS定位与C端有利残基两条规则,选出6条高分候选;另选4条模型低分肽做阴性对照,加1条已知表位做阳性对照。SureQuant的结果干净利落:6条高分候选检出2条新表位,PE13的RAAAIHDQF与EsxA的AYQGVQQKW;4条阴性对照全部落空,阳性对照如期出现。阳性预测值从无模型时代的2/286提到2/6。更进一步,把编码PE13的mRNA转进人源树突细胞,同样的表位出现在HLA-I上,这意味着这些表位原则上可以被疫苗直接靶向。
三轮筛查的账目摆在一起,模型的价值一目了然。
| 筛查 | 候选来源 | 面板规模 | 检出表位 | 阳性预测值 |
|---|---|---|---|---|
| A*02:01 第一轮 | 酵母展示结合肽(T7SS与疫苗抗原) | 286条,278条建库成功 | 2(EsxA、EsxGS) | 小于1% |
| A*02:01 文献回查 | 已发表的CD8表位 | 453条,355条建库成功 | 1(即阳性对照EsxA) | 约0.2% |
| A*24:02 模型引导 | 186条酵母展示A*24:02结合肽,经表达加结合模型打分并叠加加工规则 | 11条实测(6候选+4阴性对照+1阳性对照) | 3(2条新表位+阳性对照) | 2/6,约33% |
这项工作最值得称道的地方是它对自家阴性结果的诚实——两千五百万个细胞只换来两条肽,作者没有把它包装成灵敏度的胜利。但作为靶向质谱的同行,笔者想指出这套“预测什么找什么”的确认模式有几处需要小心解读的地方。首先,面板本身经过了双重截断:酵母展示只测九肽,SIL标准合成与建库成功(286条中278条)又是一道闸门,真正进仪器视野的已经是候选空间的一个切片;而检测下限标定只覆盖了7条肽,其余候选各自的离子化效率与回收率差异并未逐一校正,某条肽没被检出究竟是没被呈递还是低于它自己的下限,严格说无法分辨,作者用“低到这个程度的呈递可能连T细胞都看不见”来兜底,这个辩护成立的前提恰恰是那个未被验证的假设。其次,加工模型的负例定义有循环的味道:“酵母展示阳性但SureQuant未检出”把检测上限当成了生物学阴性,模型学到的部分内容可能是哪些肽好测,而非哪些肽被加工。再次,表达分数与分泌水平高度相关,它可能部分是T7SS通量的代理变量,而转录组只取了五个供体、单一时间点的均值。还有,全部阳性加起来只有4条表位、两个等位基因,AUPRC的置信区间宽到无法排除相当大的模型方差,HLA匹配的训练-测试划分也只有一种方式。最后,前提本身——T7SS底物在MHC-I配体组中的富集——继承自同一实验室的非靶向分析,其检索口径(XCorr不低于2.0加Percolator q值0.05)比免疫肽组学惯用的1%错误发现率宽松一档,富集强度对这个参数是敏感的。
把这些数字放回更大的背景里看,这篇论文其实是在给“免疫优势”这个老问题做算术。作者此前发展的PathMHC代表了另一条路线——用色谱对齐从非靶向数据里捞出感染特异的未鉴定前体,再回头用靶向方法确认[7]。两条路线共同指向一个正在成形的范式:计算工具负责提名,靶向质谱负责裁决。对预测器的使用者也一样:牛痘病毒2256条预测表位里,49条撑起了94%的CD8应答[8],免疫优势从来是呈递、加工与前体频率的乘积,而不是结合亲和力的排行榜[9]。对结核疫苗,可操作的结论是把靶点从“预测高分肽”收缩到高表达、被分泌、C端侧翼可加工三者的交集;对肿瘤新抗原领域,这套逻辑同样紧迫——交叉呈递下的加工规则与内源性呈递并不同,而这一领域的预测器,至今仍在用自己的训练数据为自己打分[10]。
参考文献
- Leddy O, Gunnarsson C, Holec PV, Ren D, Martello C, Birnbaum ME, White FM, Bryson BD. Multiple bottlenecks constrain presentation of Mycobacterium tuberculosis antigens on MHC class I. bioRxiv (2026). DOI: 10.64898/2026.10.16.759551
- Leddy O, White FM, Bryson BD. Immunopeptidomics reveals determinants of Mycobacterium tuberculosis antigen presentation on MHC class I. eLife 12, e84070 (2023). DOI: 10.7554/eLife.84070
- Holec P, et al. High-throughput screening for class I peptide MHC binding via yeast surface display. Proc Natl Acad Sci USA (2025). DOI: 10.1073/pnas.2514741122
- Leddy O, Stopfer LE, Flower CT, et al. Validation and quantification of peptide antigens presented on MHCs using SureQuant. Nat Protoc (2024). DOI: 10.1038/s41596-024-01076-x
- Sarkizova S, Klaeger S, Le PM, et al. A large peptidome dataset improves HLA class I epitope prediction across most of the human population. Nat Biotechnol 38, 199-209 (2020). DOI: 10.1038/s41587-019-0322-9
- Sijts AJ, Neisig A, Neefjes J, Pamer EG. Two Listeria monocytogenes CTL epitopes are processed from the same antigen with different efficiencies. J Immunol 156, 683-692 (1996). DOI: 10.4049/jimmunol.156.2.683
- Leddy O, Yuki Y, Carrington M, Bryson BD, White FM. Targeting infection-specific peptides in immunopeptidomics studies for vaccine target discovery. J Exp Med 222, e20250444 (2025). DOI: 10.1084/jem.20250444
- Moutaftsi M, Peters B, Pasquetto V, et al. A consensus epitope prediction approach identifies the breadth of murine TCD8+-cell responses to vaccinia virus. Nat Biotechnol 24, 817-819 (2006). DOI: 10.1038/nbt1215
- Yewdell JW, Bennink JR. Immunodominance in major histocompatibility complex class I-restricted T lymphocyte responses. Annu Rev Immunol 17, 51-88 (1999). DOI: 10.1146/annurev.immunol.17.1.51
- InstaDeep et al. BenchMHC: a reproducible framework for peptide-MHC presentation prediction. bioRxiv (2026). DOI: 10.64898/2026.10.22.760998
内容经AI校正和润色,审慎阅读