原文见笔者个人网站 www.liangxiao.pro。内容经AI校正和润色,可能存在不准确之处,仅供研究参考。
免疫肽组学的标准读法是物理证据:抗体把 HLA 复合物从组织里拉下来,质谱报出序列,剩下的问题交给预测和验证。这套读法有一个长期悬而未决的盲区——呈递不等于被识别。一份肿瘤标本上挂着成千上万条配体,其中绝大多数是”乘客”,T 细胞并不会看它们一眼;真正被肿瘤浸润淋巴细胞识别的那一小撮,在常规流程里没有任何标签。约翰霍普金斯医学院 Hui Zhang 团队在 Research Square 上发布的预印本试图给这个盲区装上探针:他们把受体捕获直接接进免疫肽组学流程,在同一份 10 毫克临床组织里顺序分离免疫肽组,再用组织自己的 IgG 和 TCR 去钓那些”被看见”的配体[1]。
平台的工程思路是串联 depletion。裂解液先过蛋白 G 珠子收走内源 IgG 及其结合肽(nIgG),流穿液依次再过 HLA-II 抗体鸡尾酒(TAL-1B5/EPR11226/B-K27)、W6/32 收 HLA-II 和 HLA-I,最后用抗 TCRαβ 抗体收走天然状态下与 TCR 复合的肽段(nTCR)。在这个主轴之外,作者设计了一个再平衡步骤:把 HLA-I/II 富集所得肽段的一半,与同一标本留存下来的珠结合 IgG 或 TCR 蛋白共孵育,洗去”低亲和力乘客”后酸洗脱,得到 bIgG 和 bTCR 组分。全部六个层级的馏分在 timsTOF HT 上以 DDA-PASEF 读出,FragPipe 无酶检索、1% FDR。30 例肾透明细胞癌(18 例原发瘤、12 例配对癌旁)跑下来,得到 38,848 条唯一 HLA-I 肽和 26,961 条唯一 HLA-II 肽。
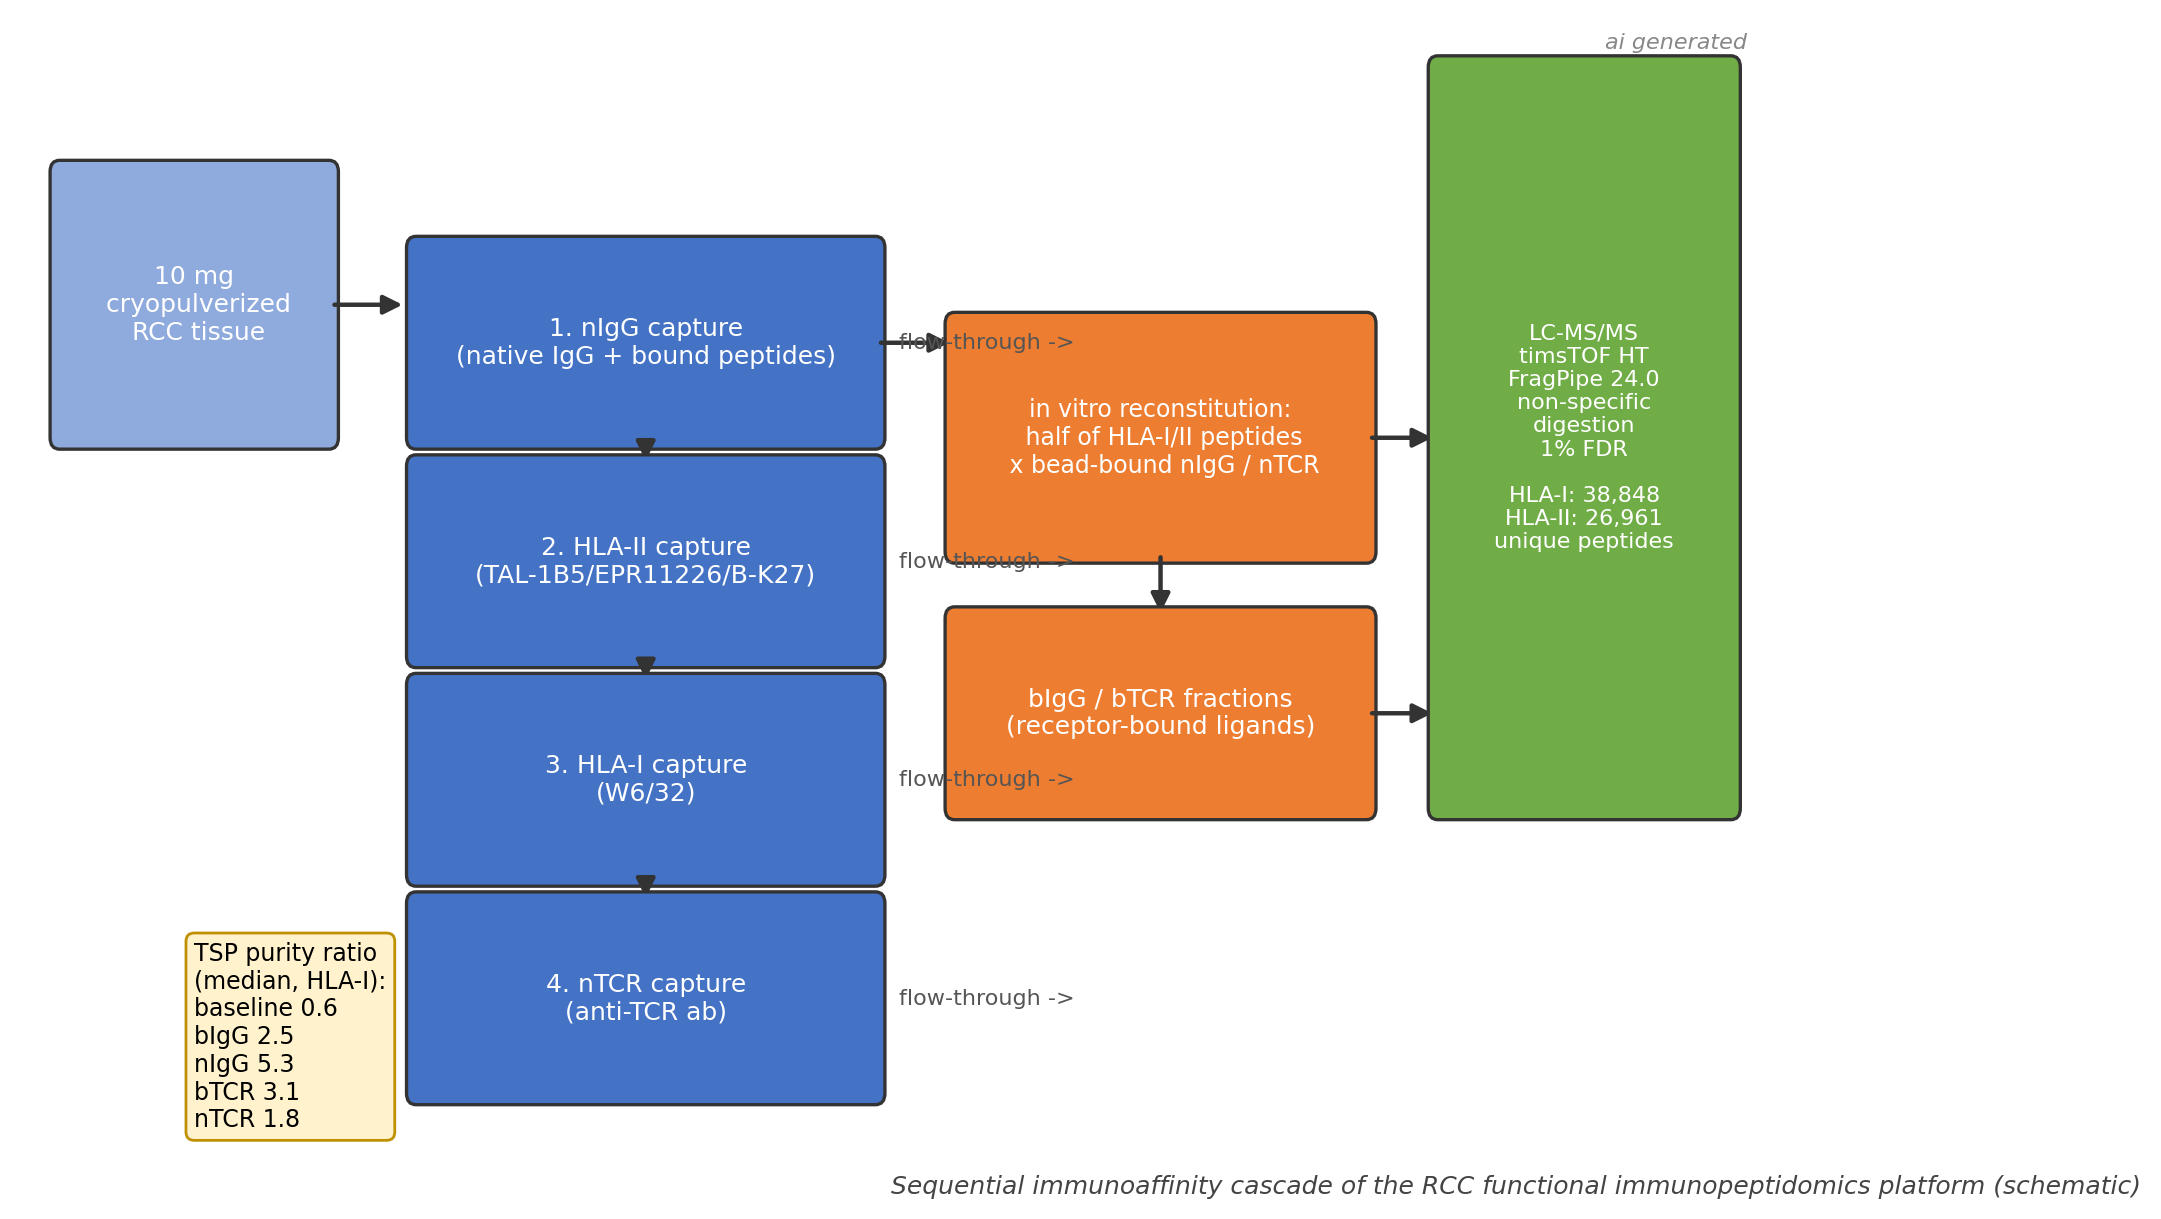
按层拆开看,HLA-II 侧基线 20,558 条、nIgG 2,475 条、nTCR 1,832 条,再平衡后 bIgG 7,609 条、bTCR 4,538 条;HLA-I 侧基线 33,487 条,四个受体组分合计约 1.5 万条。关键指标是肿瘤特异性肽(TSP)纯度比:与配对癌旁做扣除后,基线 HLA-I 的中位纯度比只有 0.6,而受体组分升到 2.5(bIgG)、5.3(nIgG)、3.1(nTCR)与 1.8(bTCR)。摘要里那句”最高 5.3 倍”就来自 nIgG——值得注意的是它来自抗体而非 TCR 捕获。免疫热型肿瘤在所有受体组分上的纯度比都高于冷型,这与”浸润免疫细胞越多、被识别配体越富”的直觉一致。
| 组分 | HLA-I 唯一肽 | HLA-I TSP | 中位纯度比 | HLA-II 唯一肽 | HLA-II TSP |
|---|---|---|---|---|---|
| 基线 HLA | 33,487 | 20,118 | 0.6 | 20,558 | 8,967 |
| nIgG | 1,376 | 344 | 5.3 | 2,475 | 784 |
| bIgG | 4,618 | 1,840 | 2.5 | 7,609 | 3,418 |
| nTCR | 2,719 | 201 | 3.1 | 1,832 | 331 |
| bTCR | 5,886 | 2,451 | 1.8 | 4,538 | 1,486 |
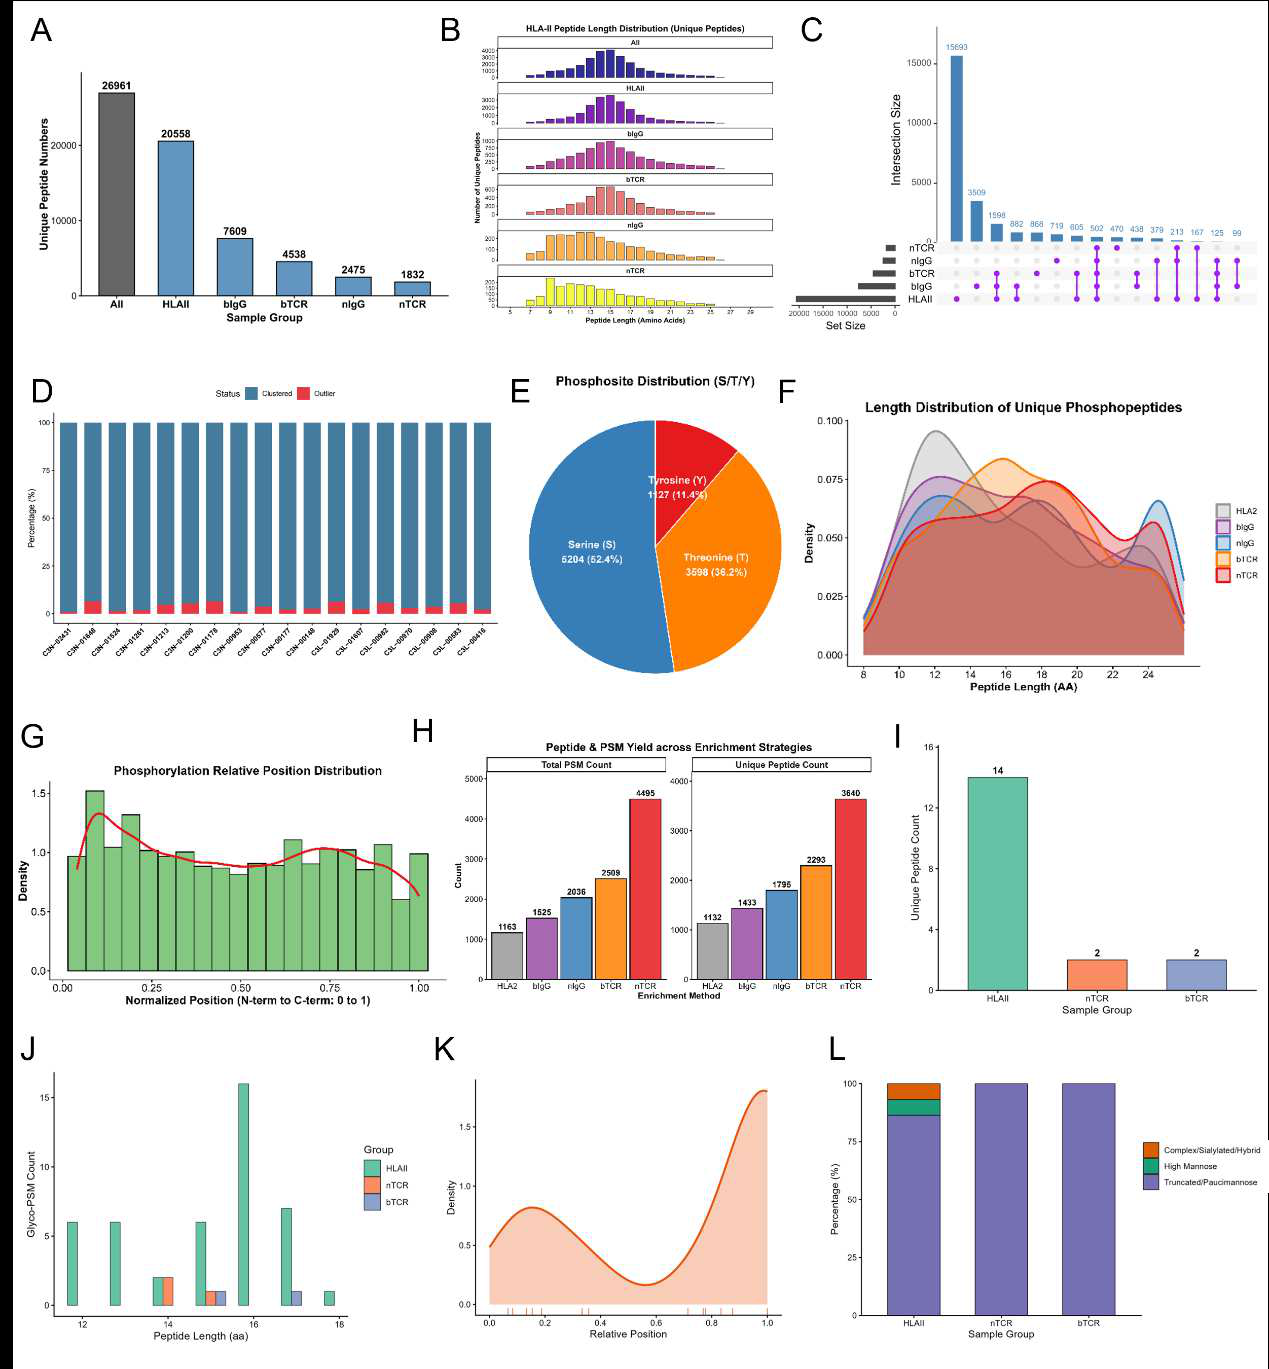
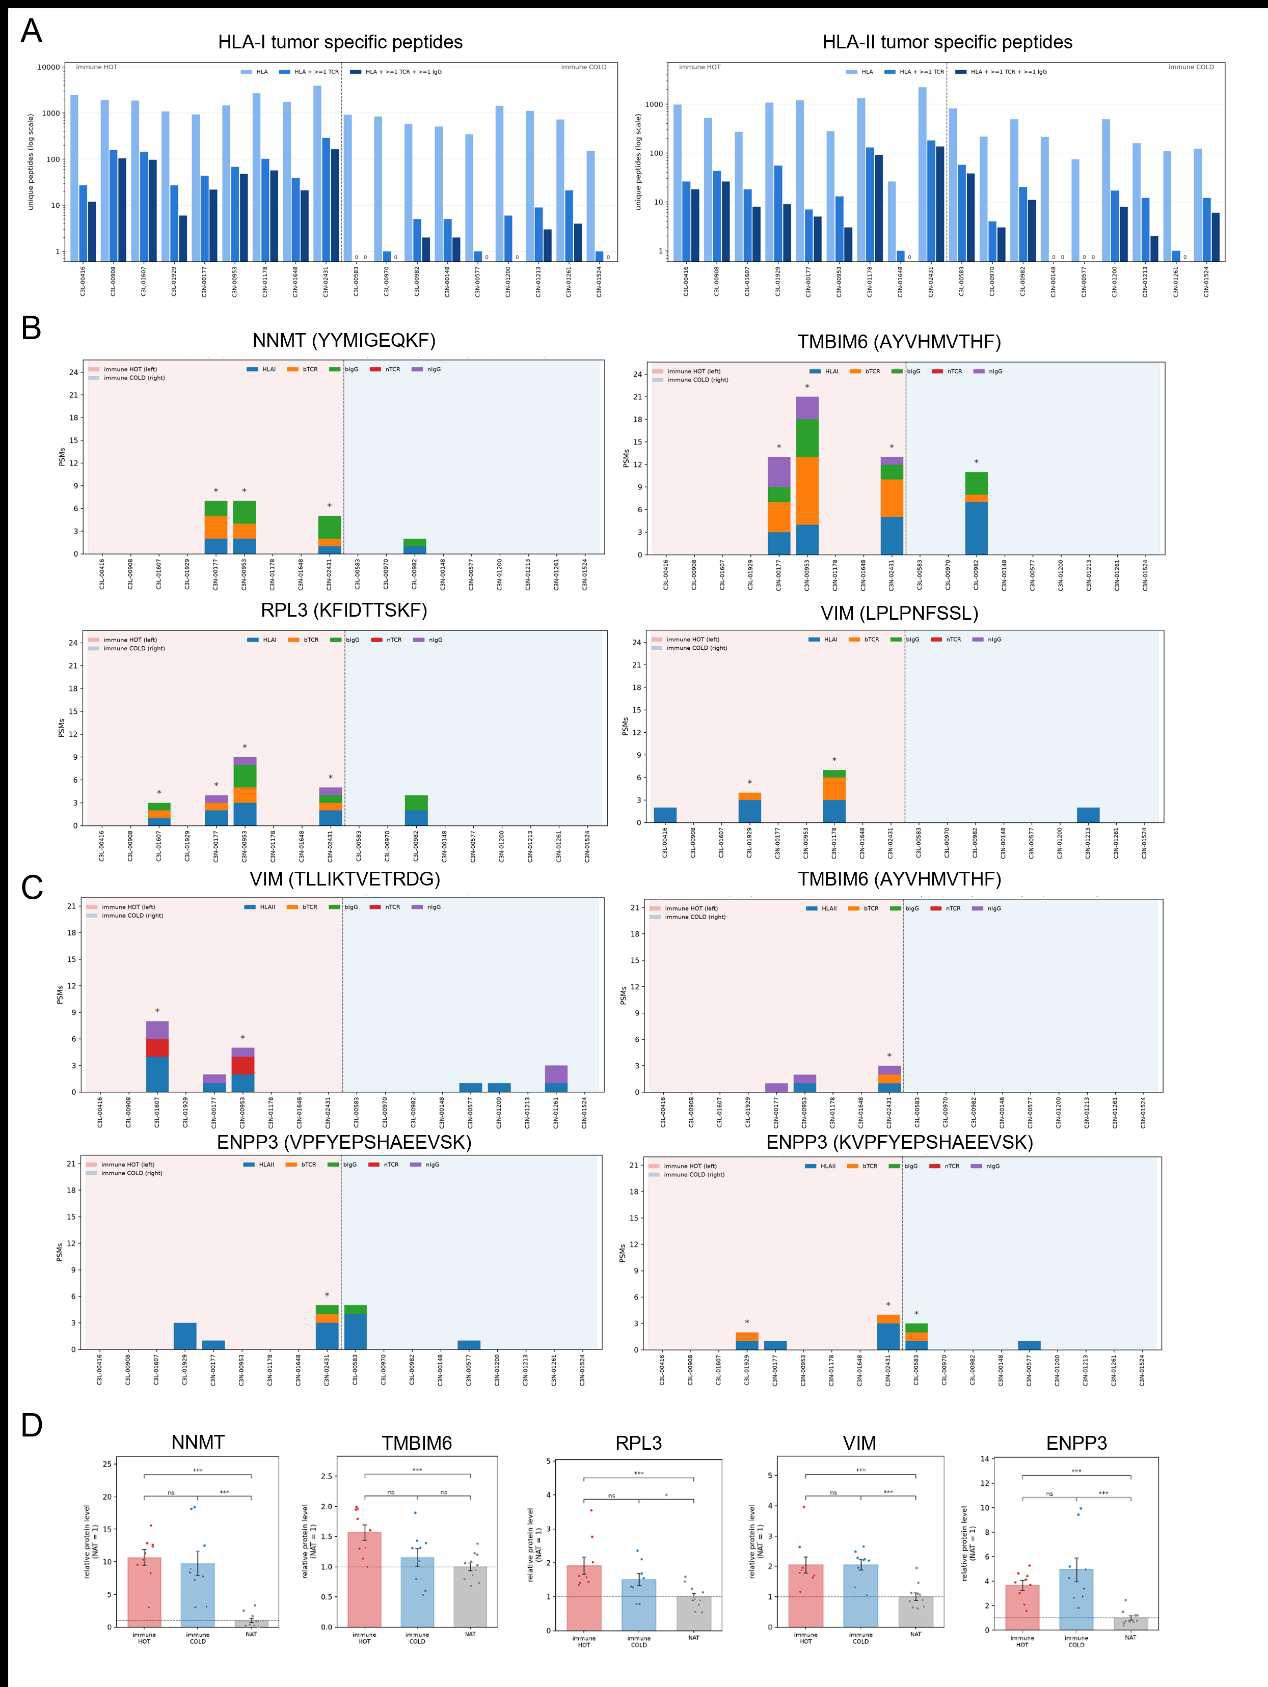
跨组分共鉴定是全文最有说服力的部分。同一患者标本里,相当一部分肿瘤特异性肽同时出现在基线 HLA、TCR 与 IgG 组分中——作者称之为内部正交验证,认为双重(HLA+TCR)与三重(HLA+TCR+IgG)识别状态的肽段是优先靶点。反复出现的未突变靶点包括 NNMT(YYMIGEQKF)、TMBIM6、RPL3、VIM 与 ENPP3,其亲本蛋白在配套全局蛋白组中均于肿瘤侧显著上调。磷酸化侧则呈现出高度的个体异质性:HLA-II 磷酸肽共 7,310 个 PSM,一个标本(C3N-01648)独占超过 1,400 个,而它的全局基线产量反而不高;共享磷酸肽来源蛋白由 TTN、MUC16 这类巨蛋白领衔,hub 蛋白包括 EN2、FLNA、FLT4、FES。糖肽一翼相对薄弱——N-糖肽总共只有十几条序列,但 CD68 来源的巨噬细胞限制性糖肽只在免疫热型中出现,给出了一个微环境标签而非靶点的证据。
第二部分是蛋白组学整合后的”机制”叙事。HLA-I 呈递通量(PSM 总数)与组织 HLA-I 蛋白丰度呈线性相关(R=0.883),TAP1、TAP2、STAT1 与之高度耦合,GSEA 显示 APM 程序在免疫热型中整体上调——作者把它总结为 STAT1 驱动的转录级联线性放大。HLA-II 则解耦:与亲本蛋白丰度只有 R=0.302 且不显著,内溶酶体转运、组织蛋白酶等下游模块在热冷之间碎裂化表达,C3N-01648 的高 CTSL/CTSB 伴随全局肽产量下降,作者推断是过度酶切把未修饰底物切碎到无法装载,而磷酸化修饰或许提供了空间位阻保护。

以笔者的质谱本行看,这篇文章的工程贡献是实的,生物学结论则有几处需要打折。最扎眼的是再平衡结合实验的化学基础。TCR 识别的是约束在 MHC 沟槽里的肽,对游离肽基本没有可测的结合力——这是结构免疫学的常识;裸 IgG 对线性游离肽的亲和力通常也只有 hapten 情形下的例外水平。那么 bTCR/bIgG 组分里那四千到七千条肽究竟靠什么留在珠子上?文中没有给出任何阴性对照:没有无关受体的珠子、没有乱序肽竞争、没有洗脱动力学曲线。在没有对照的情况下,”受体结合富集”完全无法与非特异吸附( bead、Sepharose、抗体 Fc、Ig 重链残留)区分,纯度比的提升同样可能来自疏水性或丰度偏倚的选择性保留。nIgG 的 5.3 倍纯度也值得推敲:肿瘤裂解液里的内源 IgG 夹杂大量 Fc 受体来源的免疫复合物,其”肿瘤特异性”未必反映抗体识别。作者在讨论里坦承体外再平衡没有捕捉下游信号与激活动力学,但没有正面回应结合特异性这一更根本的问题。
其次,共鉴定作为正交验证的效力依赖于串级流程的零串扰假设。四个捕获步骤共用同一条流穿链,任何一级的洗涤残留都会把上游肽段带进下游馏分,使”多重识别”被高估。同一 PSM 在相邻馏分重复出现,与真实受体结合和操作残留在数据上无法区分,除非有交换实验或标记验证。TSP 的定义也有不对称性:跨队列的 NAT 扣除意味着”NAT 没测到”与”NAT 低于检出限”被合并处理,而肿瘤与癌旁的样本处理量、免疫细胞含量差异都会偏向肿瘤侧。
第三,HLA-II”解耦”的因果解释偏强。R=0.302 在 n=30 下不显著,这是描述性结论;把它归因于内溶酶体过度酶切与磷酸化位阻保护,需要酶活性测定、抑制实验或体外降解级联的直接证据。作者引用的是蛋白丰度异质性这一个观察,从观察到机制之间隔了整整一层。磷酸化肽作为免疫靶点的潜力本身并不新[4],糖肽新抗原在白血病中早有先例[5],本文的新意在于把 PTM 维度塞进微输入流程,这部分是成立的。
放在更大的图景里,这篇预印本呼应了免疫肽组学这两年最核心的自我怀疑:物理呈递与功能识别之间隔着巨大的鸿沟。Messemaker 等人今年在 Immunity 上报告约半数已发表 TCR-pMHC 反应性在标准化复评中不复现[7],TScan 一系的筛选工作反复显示预测管线的盲区,而 HLA Ligand Atlas 这样的良性参照库又不断压缩”肿瘤特异”的名义空间[6]。如果受体捕获确实能工作(这是本文尚未完全证明的),它提供的正是从呈递列表到功能靶点之间缺失的那道过滤。对低 TMB 的肾癌而言,这条路径的吸引力尤其大——ICI 敏感[2]而突变新抗原稀少,非突变 TSA 是唯一说得通的解释,CPTAC 的蛋白组学框架[3]也已经为这类整合分析铺好了配套数据。方案的最终价值取决于阴性对照与独立验证能否补上;在预印本阶段,把它读作一个值得复现的工程框架,比读作一套可用的靶点清单更接近事实。
- Liu H, Wei E, Hu Y, Wang Y, Sun Z, Zhang H. Functional Immunopeptidomics by Characterizing Immunopeptides Against HLAs, TCRs, and Antibodies. Research Square, posted October 8, 2026. https://doi.org/10.21203/rs.3.rs-11040221/v1
- Motzer RJ, Escudier B, McDermott DF, et al. Nivolumab versus Everolimus in Advanced Renal-Cell Carcinoma. N Engl J Med. 2015;373(19):1803-1813. https://doi.org/10.1056/NEJMoa1510665
- Clark DJ, Dhanasekaran SM, Petralia F, et al. Integrated Proteogenomic Characterization of Clear Cell Renal Cell Carcinoma. Cell. 2019;179(4):964-983. https://doi.org/10.1016/j.cell.2019.10.007
- Mohammed F, et al. The antigenic identity of human class I MHC phosphopeptides is critically dependent upon phosphorylation state. Oncotarget. 2017;8(40):68033. https://doi.org/10.18632/oncotarget.16952
- Malaker SA, et al. Identification of Glycopeptides as Posttranslationally Modified Neoantigens in Leukemia. Cancer Immunol Res. 2017;5(7):876. https://doi.org/10.1158/2326-6066.CIR-16-0280
- Marcu A, et al. HLA Ligand Atlas: a benign reference of HLA-presented peptides to improve T-cell-based cancer immunotherapy. J Immunother Cancer. 2021;9(4):e002071. https://doi.org/10.1136/jitc-2020-002071
- Messemaker UMF, et al. Functional evaluation of TCR-pMHC pairs at scale allows in silico TCR reactivity prediction. Immunity. 2026. https://doi.org/10.1016/j.immuni.2026.09.007
内容经AI校正和润色,审慎阅读