原文见笔者个人网站 www.liangxiao.pro。内容经AI校正和润色,可能存在不准确之处,仅供研究参考。
过去四年,de novo 肽测序的深度学习模型几乎以每年两三个的速度出现[1]:transformer 架构的 Casanovo[2]、扩散模型驱动的 InstaNovo[3]、非自回归的 π-PrimeNovo[4],各自都报告了亮眼的数字。模型之间究竟差在哪里、能否处理天然存在的歧义谱图,却一直没有同一把尺子。根特大学 VIB 的 Martens 与 Claeys 实验室联合图尔库 Elo 组与柏林联邦风险评估研究所在 Nature Methods 上线的工作,把这八个模型放进同一条 Nextflow 管线,用三个公开数据集和统一指标做了系统基准[1]。结论比模型发布会上的叙事冷静得多:多数测序错误与模型无关,天花板不在网络结构里,而在谱图本身。
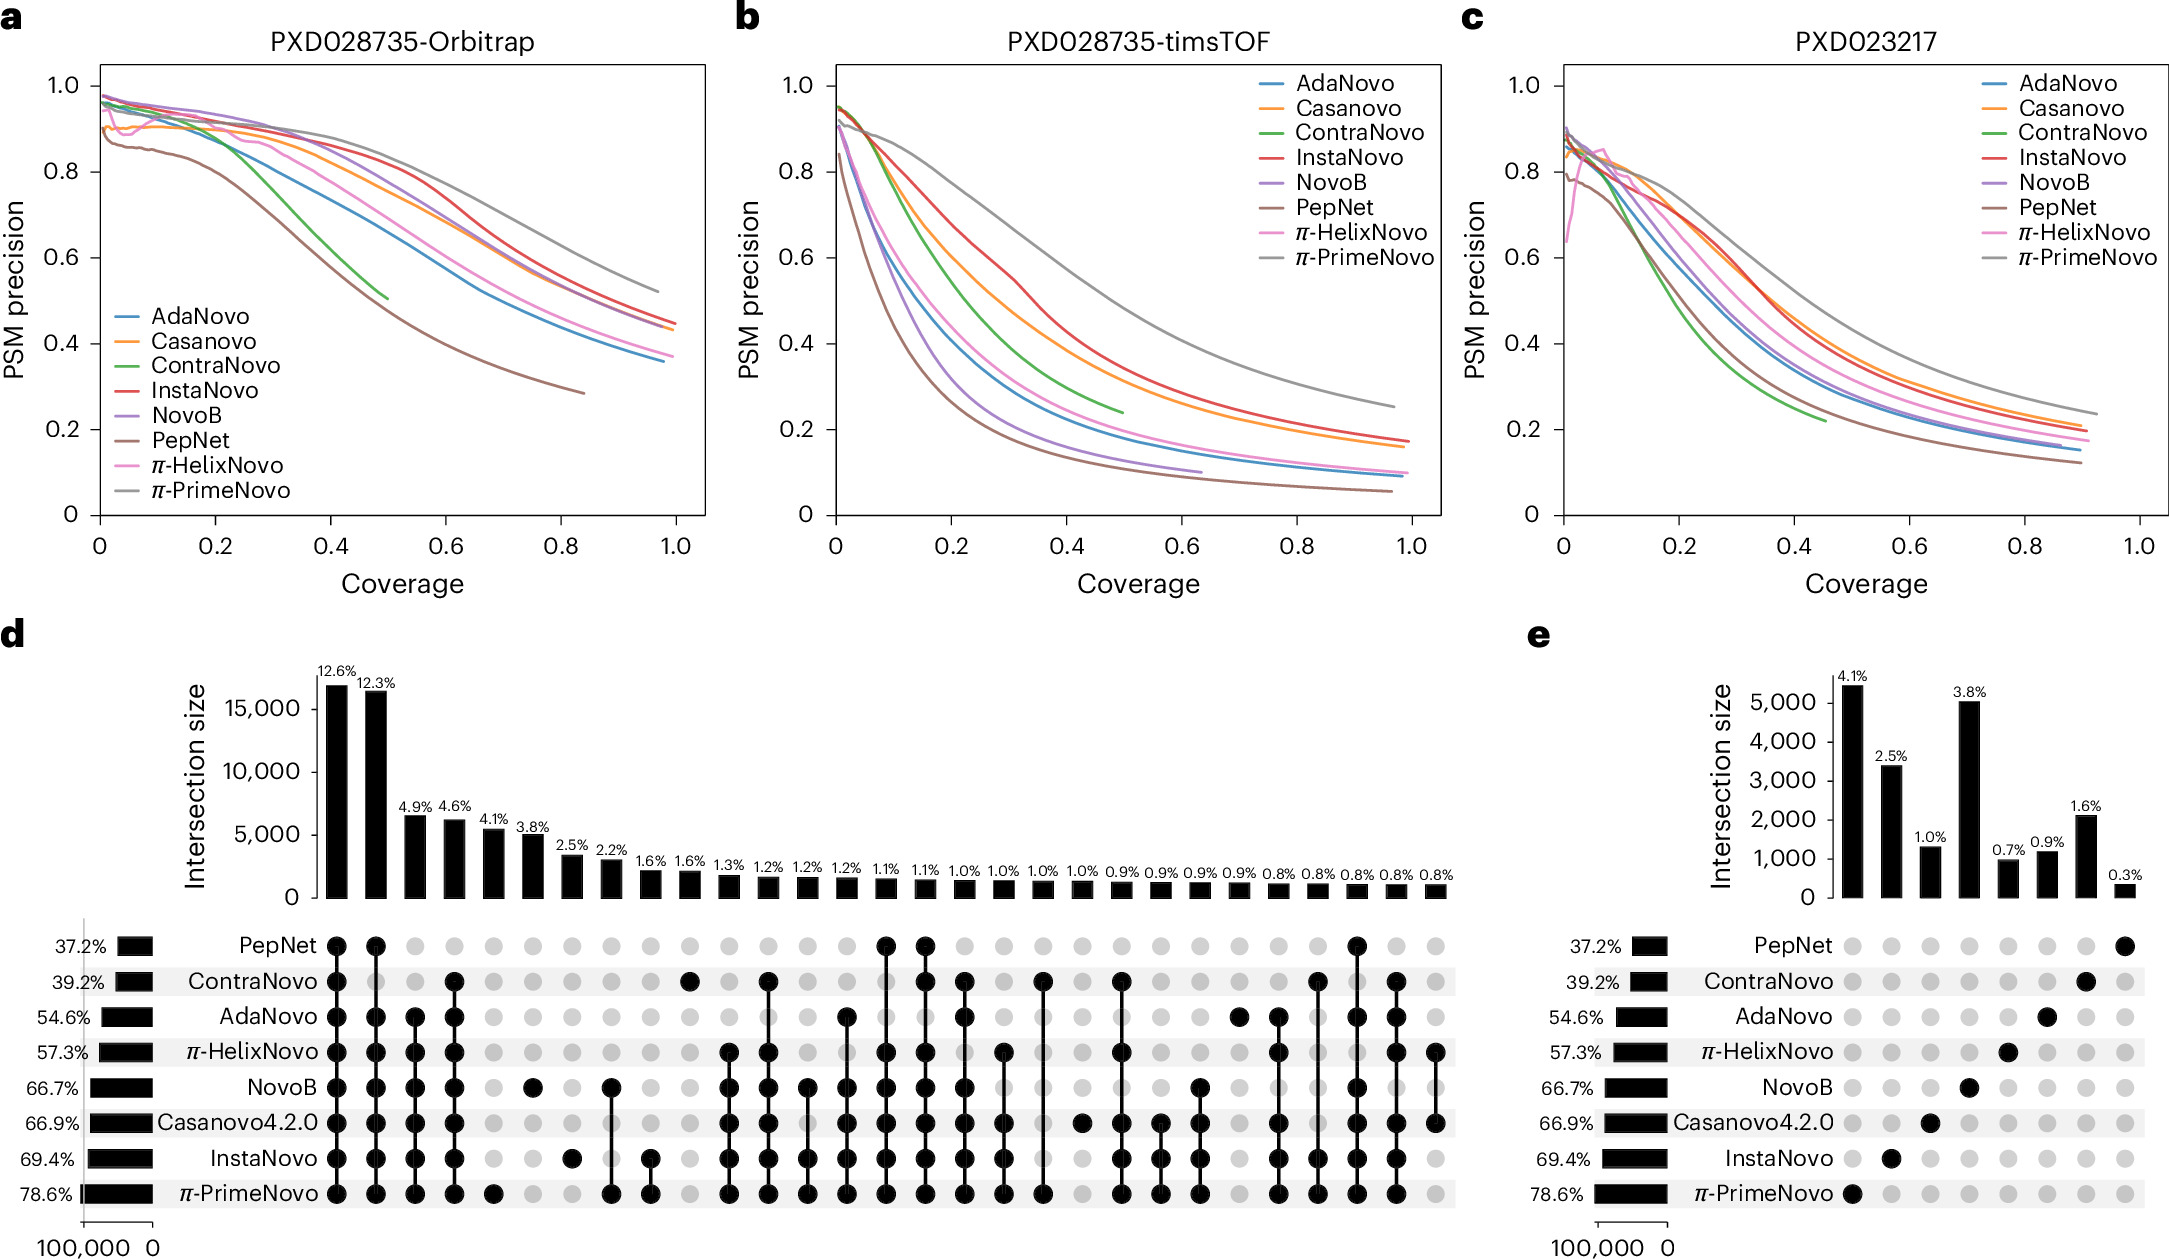
基准的设计有几处值得注意。金标准不是“真值”而是数据库搜索:Sage 以 chimeric 模式加 MSGF+ 在 q 值 0.01 下鉴定,并故意保留每张谱的多条肽,以容纳共碎裂谱图[5][6];预测与其中任一鉴定肽一致即算正确。三个数据集分别是三物种混合物在 QE-HFX Orbitrap 与 timsTOF Pro2 上的双平台采集(PXD028735)和 CAMPI 八物种模拟宏蛋白组(PXD023217)。precision-coverage 曲线的排序里,π-PrimeNovo 以 78.6% 居首,InstaNovo 与 Casanovo 相随,PepNet 全面垫底。两条次要发现比排名更有信息量:所有模型在 timsTOF 数据上大幅掉点,暴露出训练集几乎全是 HCD-Orbitrap 谱图的偏置;而在八物种复杂样本上 InstaNovo 与 AdaNovo 的额外滑坡,则提示对物种特异序列信息的过拟合。
一致性分析是全文最有意思的部分之一。八模型全部答对的谱只占全部正确鉴定的 12.6%,即使去掉输出残缺的 ContraNovo 与垫底的 PepNet 也只有 34.4%;π-PrimeNovo 独占 4.1% 的正确鉴定,并覆盖其他模型至少 86.6% 的正确预测。把“任何一个模型答对即算对”的理想 ensemble 拼起来,正确率从最佳单模型的 50.4% 升到 64.2%——提升显著,但离谱图信息被榨干还远。错误端则几乎没有共识:全部模型同时犯错的谱仅 0.174%,且其中 73% 的预测肽本就存在于数据库中,指向共碎裂肽的存在。
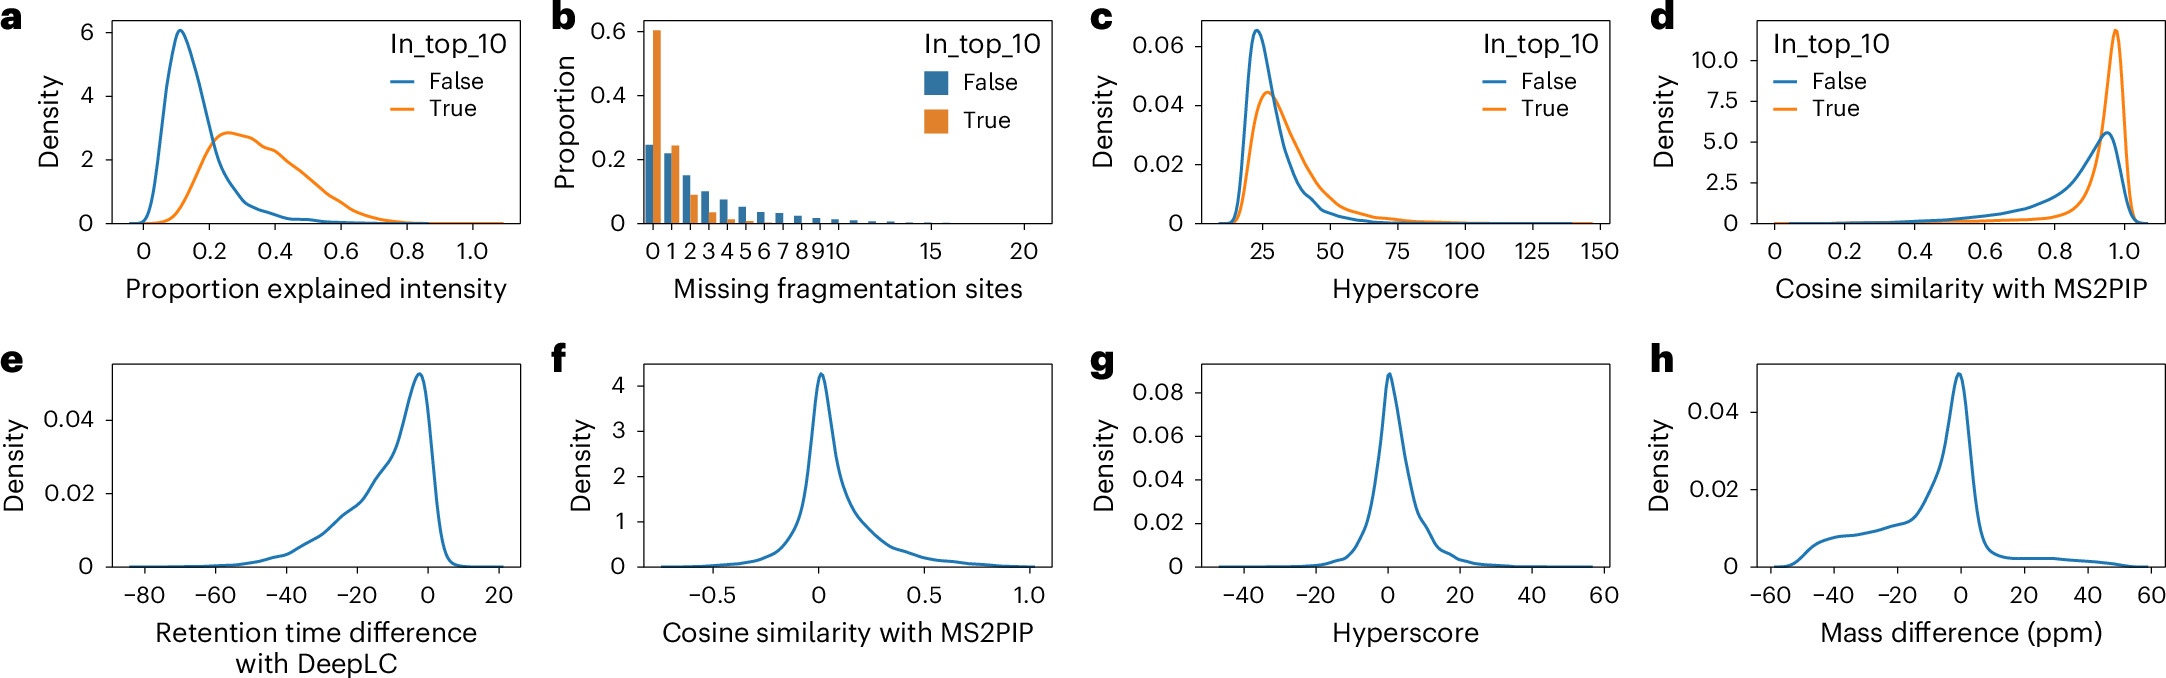
后处理是这轮 de novo 热潮里增长最快的分支,也是本文泼冷水最重的地方。序列精修模型 Spectralis[7] 把 27.6–33.3% 的候选 PSM 改写,InstaNovo+ 改写 8.2–35.3%,但净增益边际到不存在:对 Casanovo 和 π-PrimeNovo 这类本身较强的模型,精修反而减少了正确 PSM——改对的不多,改错的产物几乎都不在数据库里。重打分方面,MS2Rescore 式的方法在数据库检索中 20–35% 的增益早已确立[8][9][10],搬到 de novo 上却只换来 PC 曲线下面积的温和改善。真被纠正的案例都局限于两个氨基酸以内的替换,此时重打分分数确实偏向修正后的序列;分歧发生在初始预测本来就正确、而精修模型仍坚持改写的场景。
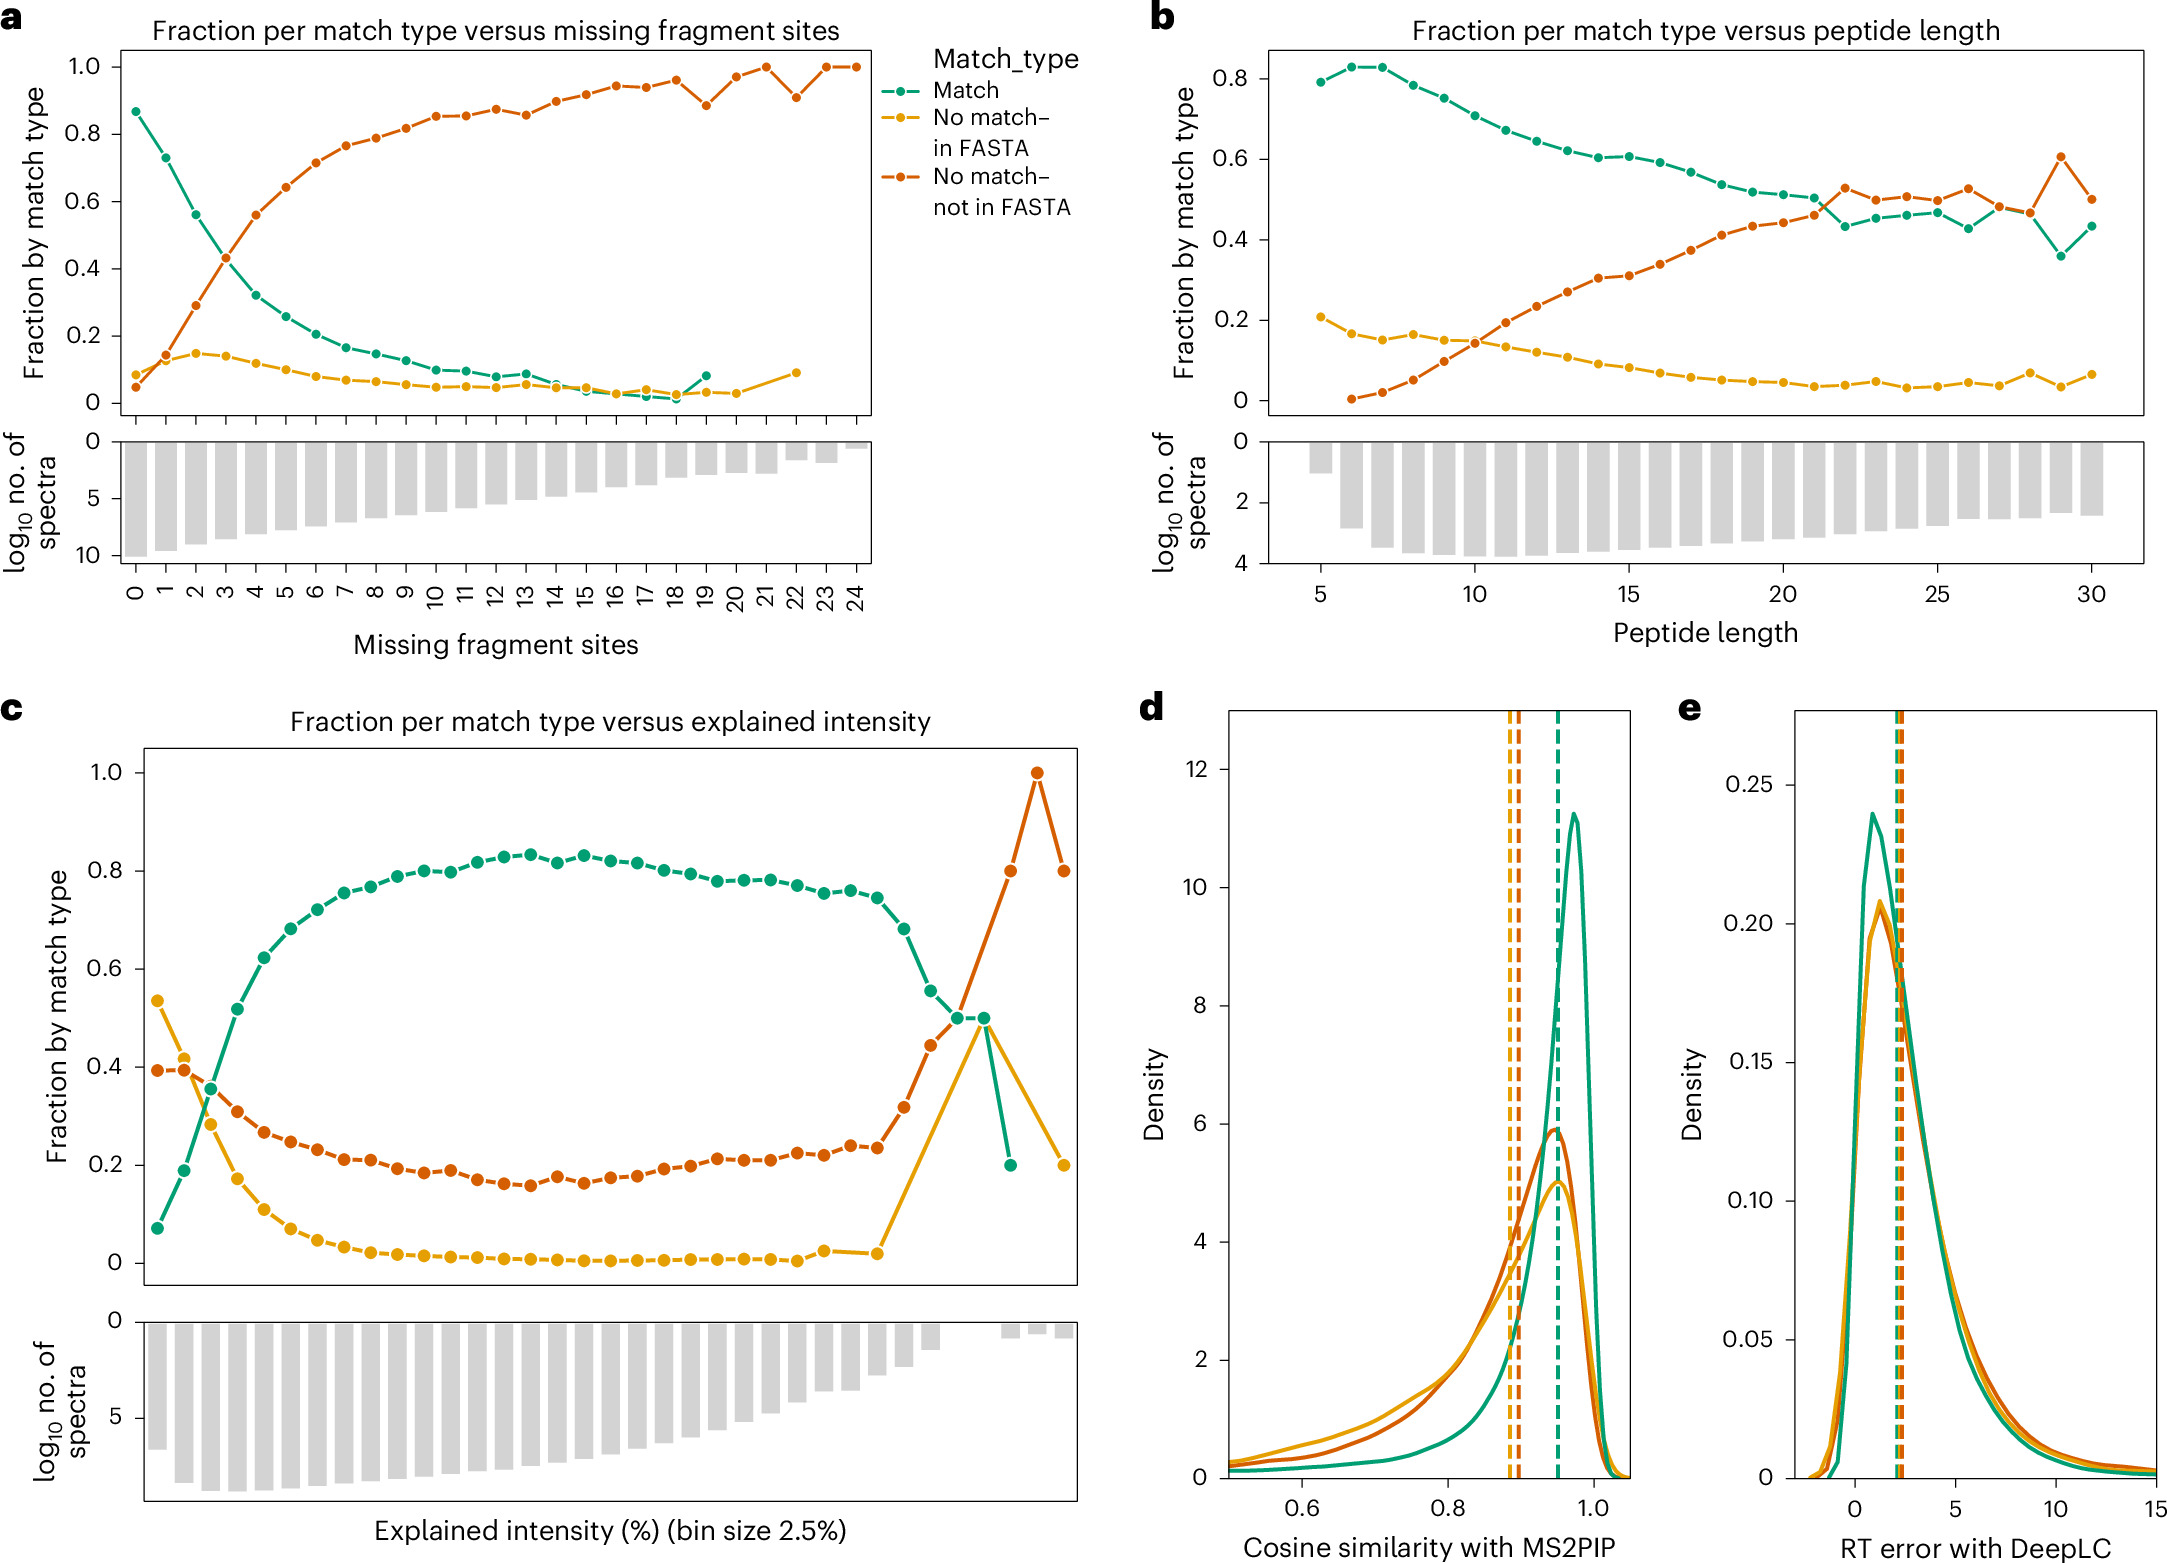
错误解剖给出更根本的数字。预测与真值的编辑距离呈双峰——要么几乎全对,要么面目全非。单氨基酸变异只占 0.77–3.95%,以 N/Q 的脱酰胺形式为主,PepNet 还独有一类恰好差一个甘氨酸的位移(AG↔Q、GG↔N),源于其从完整概率矩阵重建序列的机制局限。局部错误约占五分之一,其中双氨基酸换位有 68.5% 找不到任何能区分两种候选的诊断碎片离子,同分异构 tag 约一半同样无解;这些错误系统性偏向 C 端,而当前主流模型恰恰大多从 C 端向 N 端生成序列。68.5% 这个数字的含义不是模型不行,而是两种候选肽在谱图里根本无法区分——信息不存在,猜对只是运气。大型错误占大头,平均 20.0% 的错误预测与真值完全不同,共碎裂肽假说解释不了这么大的比例。
| 错误类别 | AdaNovo | Casanovo | ContraNovo | InstaNovo | NovoB | PepNet | π-HelixNovo | π-PrimeNovo |
|---|---|---|---|---|---|---|---|---|
| 单氨基酸变异 | 0.87 | 1.05 | 1.61 | 2.96 | 0.77 | 2.51 | 0.90 | 3.95 |
| 局部·重排 | 4.11 | 4.97 | 5.99 | 4.12 | 6.73 | 2.88 | 4.04 | 6.92 |
| 局部·同分异构 | 5.49 | 6.67 | 8.05 | 5.40 | 8.90 | 4.33 | 6.02 | 8.97 |
| 大型·完全不同 | 24.78 | 23.43 | 21.67 | 22.37 | 12.45 | 18.59 | 22.20 | 14.87 |
| 大型·部分不同 | 40.62 | 38.22 | 29.37 | 39.38 | 29.23 | 44.46 | 39.46 | 34.78 |
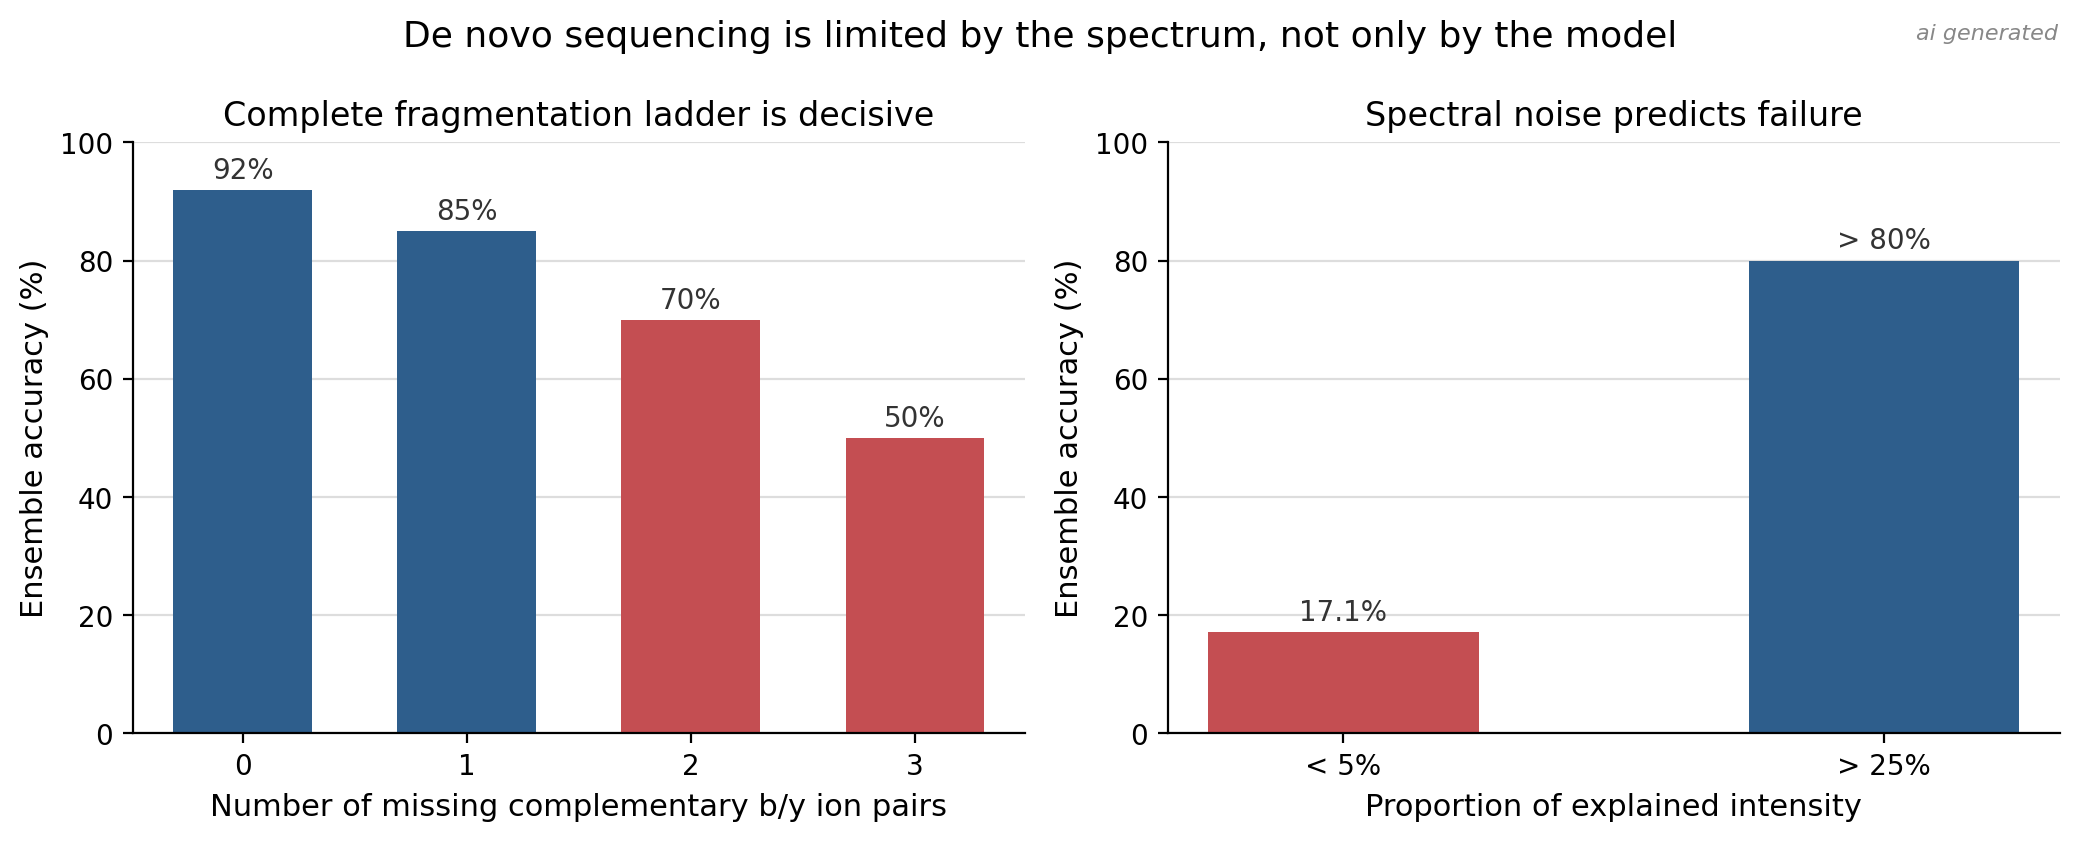
谱图特征把这一点钉死。八模型理想 ensemble 的正确率在互补 b/y 离子全覆盖的谱上达到 92%,缺一对互补离子降到 85%,缺两对 70%,缺三对 50%;解释强度低于 5% 的谱只有 17.1% 被任何模型答对,高于 25% 时超过 80%。肽长效应看似存在,实则被碎片完整性混淆——长肽天然更容易缺离子。作者指出同样的机制也限制大搜索空间的数据库检索,只是 de novo 把搜索空间放到最大,歧义无处可藏。
这项基准自身有边界。金标准以数据库搜索定义“正确”,而搜索引擎的鉴定本身受同一个碎片覆盖问题制约——作者用 chimeric 模式、双引擎与高分一致性分析做了缓解,但 64.2% 的 ensemble 上界读数仍依赖这一定义。三个数据集全部是常规 DDA 的 HCD 与 timsTOF 人、菌、酵母场景,免疫肽组学里无酶切、修饰空间大、梯度短的谱图完全未被触及,而这恰恰是 de novo 最有实用价值的领域——没有库可查。timsTOF 与 ETD 上的泛化失败说明预训练模型继承的是特定碎片化方法的分布,迁移学习被点到为止。
论文同时把整套基准集成进 ProteoBench,希望把社区注意力从工具竞争挪到透明评估[11]。对做 HLA 免疫肽组学的人,这篇论文的读法是反向的:与其期待下一个模型在短梯度 DIA 谱图上变魔术,不如回到采集端——更完整的碎片系列、多种碎裂方式的多次采集——先把谱图里那 92% 的格子做厚。模型竞赛还在继续,但给定一份数据,信息量已经先见了顶。
参考文献
- van Puyenbroeck S, Beslic D, Suomi T, Holstein T, Muth T, Elo LL, Martens L, Bouwmeester R, Van Den Bossche T, Claeys T. Limitations of de novo peptide sequencing in resolving sequence ambiguity. Nature Methods 2026. DOI: 10.1038/s41592-026-03301-9
- Yilmaz M, et al. Sequence-to-sequence translation from mass spectra to peptides with a transformer model. Nature Communications 2024;15:6427. DOI: 10.1038/s41467-024-49731-x
- Eloff K, et al. InstaNovo enables diffusion-powered de novo peptide sequencing in large-scale proteomics experiments. Nature Machine Intelligence 2025;7:565–579. DOI: 10.1038/s42256-025-01019-5
- Zhang X, et al. π-PrimeNovo: an accurate and efficient non-autoregressive deep learning model for de novo peptide sequencing. Nature Communications 2025;16:267. DOI: 10.1038/s41467-024-55021-3
- Lazear MR. Sage: an open-source tool for fast proteomics searching and quantification at scale. Journal of Proteome Research 2023;22:3652–3659. DOI: 10.1021/acs.jproteome.3c00486
- Kim S, Gupta N, Pevzner PA. Spectral probabilities and generating functions of tandem mass spectra: a strike against decoy databases. Journal of Proteome Research 2008;7:3354–3363. DOI: 10.1021/pr8001244
- Klaproth-Andrade D, et al. Deep learning-driven fragment ion series classification enables highly precise and sensitive de novo peptide sequencing. Nature Communications 2024;15:151. DOI: 10.1038/s41467-023-44323-7
- Declercq A, et al. MS2Rescore: data-driven rescoring dramatically boosts immunopeptide identification rates. Molecular & Cellular Proteomics 2022;21:100266. DOI: 10.1016/j.mcpro.2022.100266
- Yang KL, et al. MSBooster: improving peptide identification rates using deep learning-based features. Nature Communications 2023;14:4539. DOI: 10.1038/s41467-023-40129-9
- Buur LM, et al. MS2Rescore 3.0 is a modular, flexible, and user-friendly platform to boost peptide identifications, as showcased with MS Amanda 3.0. Journal of Proteome Research 2024;23:3200–3207. DOI: 10.1021/acs.jproteome.3c00785
- Devreese R, et al. ProteoBench: the community-curated platform for comparing proteomics data analysis workflows. bioRxiv 2025. DOI: 10.64898/2025.12.09.692895
内容经AI校正和润色,审慎阅读