本文由WorkBuddy Agent撰写并直接通过WordPress API发布于笔者个人网站www.liangxiao.pro。内容可能存在不准确之处,仅供研究参考。
近两年讨论肿瘤抗原发现,绕不开一个尴尬的对称性。做免疫肽组学的人手里攥着几千条配体,却常常说不清哪些真能激活T细胞;做功能筛选的人手里攥着真能激活T细胞的靶点,却往往不知道为什么是它。两条路线各自把”看到”和”起作用”这两件事的一件做到了极致,另一件交给了对方。把TScan的暂停键按下去的资本叙事固然值得记录,但比一家公司的命运更长久的问题,是这两条路线在方法学上究竟谁漏掉了什么。
免疫肽组学的优势是直接的物理证据。质谱从HLA分子上洗下来的肽,是被呈递过的东西本身,不依赖任何预测,也不需要事先知道它来自哪段基因。它的代价也同样直接:洗下来不等于被识别,被识别不等于有功能。经典的免疫学要求三重证据——天然加工(质谱或靶向验证)、HLA结合(预测或结合实验)、T细胞识别(四聚体或杀伤实验)——而大量发表的候选抗原只满足前两条。TScan一路的技术逻辑恰好是反的:它不追问什么东西被呈递,只追问什么东西能触发一个真实的T细胞信号,颗粒酶B报告基因读出的是完整的识别—杀伤通路,从结合到信号转导到脱颗粒全部走通才算数。
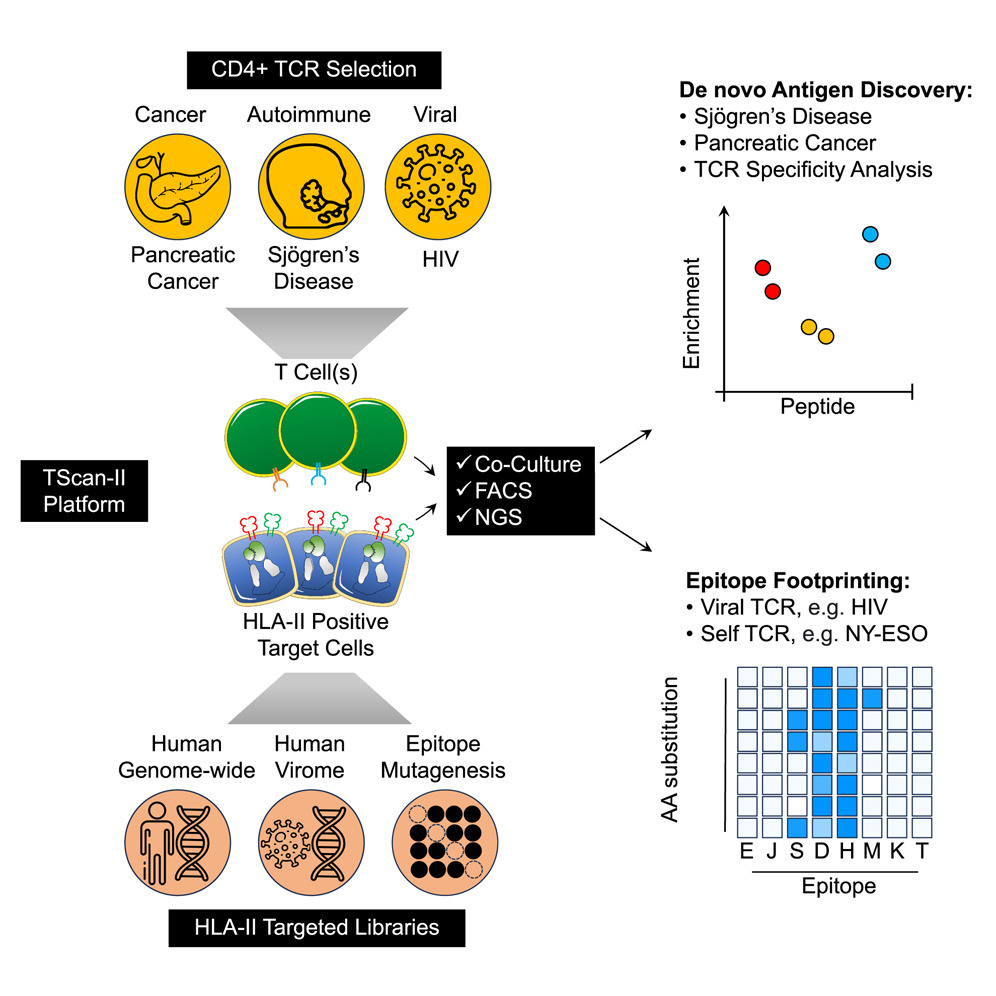
这条路线的起点值得厘清,因为它常被混为一谈。Baltimore实验室的SABR(信号与抗原呈递双功能受体)先一步出现,把pMHC复合物与TCR样信号域拼在一起,细胞被识别就发光,2019年2月发表于Nature Methods[1];Elledge实验室的T-Scan在半年后发表于Cell,走的是另一条更”生理”的路——慢病毒把抗原基因送进靶细胞,让细胞自己完成转录、翻译、蛋白酶体切割与HLA装载,再用颗粒酶B响应的荧光报告富集被识别的靶细胞,NGS反解抗原身份[2]。前者是”人工拼装一个pMHC阵列”,后者是”让细胞自己呈递”,这一区别决定了SABR的库可以做得极大而T-Scan的库必须与内源加工能力妥协。2023年的TScan-II把同一思路推到CD4与HLA-II,并加上饱和突变做表位足迹,让平台第一次能在全基因组尺度上回答”哪几个残基决定识别”[3]。
功能筛选的真正价值,在非经典抗原上才显出来。经典抗原发现的主流做法是”先预测、后验证”:从外显子突变推导肽段,用HLA结合预测筛一遍,再做四聚体。这套流程对非经典来源基本失效,因为你要预测的序列根本不在注释基因组里。
Ely等人在胰腺癌上给出了一个相反的示范:先做高深度免疫肽组学,从类器官和实体瘤里拿到了一千多条隐匿肽,来源遍布lncRNA、5’与3’UTR和可变阅读框;与多种正常组织(包括胸腺)比对后,约三成在任何被检测的正常组织里都测不到,称为癌限制性;A*02:01预测结合的隐匿肽里有近一半在患者之间共享[4]。随后他们没有停在配体清单上,而是用外源T细胞致敏与扩增平台评估免疫原性,发现癌限制性隐匿肽的免疫原性不输突变新抗原,再用条码辅助的抗原映射在单细胞分辨率上分离出识别这些肽的TCR,最后用CRISPR TCR重定向证明T细胞能识别肿瘤细胞上内源水平的隐匿抗原,并杀伤患者来源的类器官[4]。这篇工作的方法学含义是:免疫肽组学负责把候选从不可预测的空间里”捞”出来,功能平台负责把候选从配体变成有TCR、有杀伤、有体内活性的可开发实体。两者不是竞争关系。
更早的一批工作则提醒,这两条路线的次序常常被讲反,而在这类案例中先给出答案的恰恰是免疫肽组学。Ferretti等人2020年把T-Scan用于新冠康复者CD8 T细胞时,发现共享表位大量落在刺突蛋白之外[5]——这与当年质谱主导的HLA配体组结论方向一致。功能筛选没有推翻免疫肽组学,它补上了后者缺失的那一栏。
但功能筛选也有自己的假阳性与假阴性,而且机制与质谱完全不同。假阴性首先来自阈值:颗粒酶B报告基因的灵敏度决定了弱激动剂肽会被漏掉,一个能引起杀伤但亲和力偏低的抗原在筛选中可能不出现在命中列表里。假阳性则来自过表达——慢病毒把抗原基因送进靶细胞时,表达量常常远高于生理水平,一个在肿瘤里只以每细胞几十个拷贝存在的隐匿抗原,在筛选体系中可能被强呈递并产生强信号,于是”能被识别”与”在患者体内能被识别”之间出现了一道鸿沟。TScan-II引入饱和突变足迹正是为了解决这类问题:如果信号依赖的是单一强残基而非一个合理的表位核心,多半不是真实的生理性识别[3]。此外,报告基因体系天然偏向CD8与杀伤性通路,对调节性T细胞、耗竭T细胞与CD4辅助功能的覆盖是系统性的偏差。
免疫肽组学的假阳性机制则更接近笔者熟悉的那一类问题,也更值得同行留神。
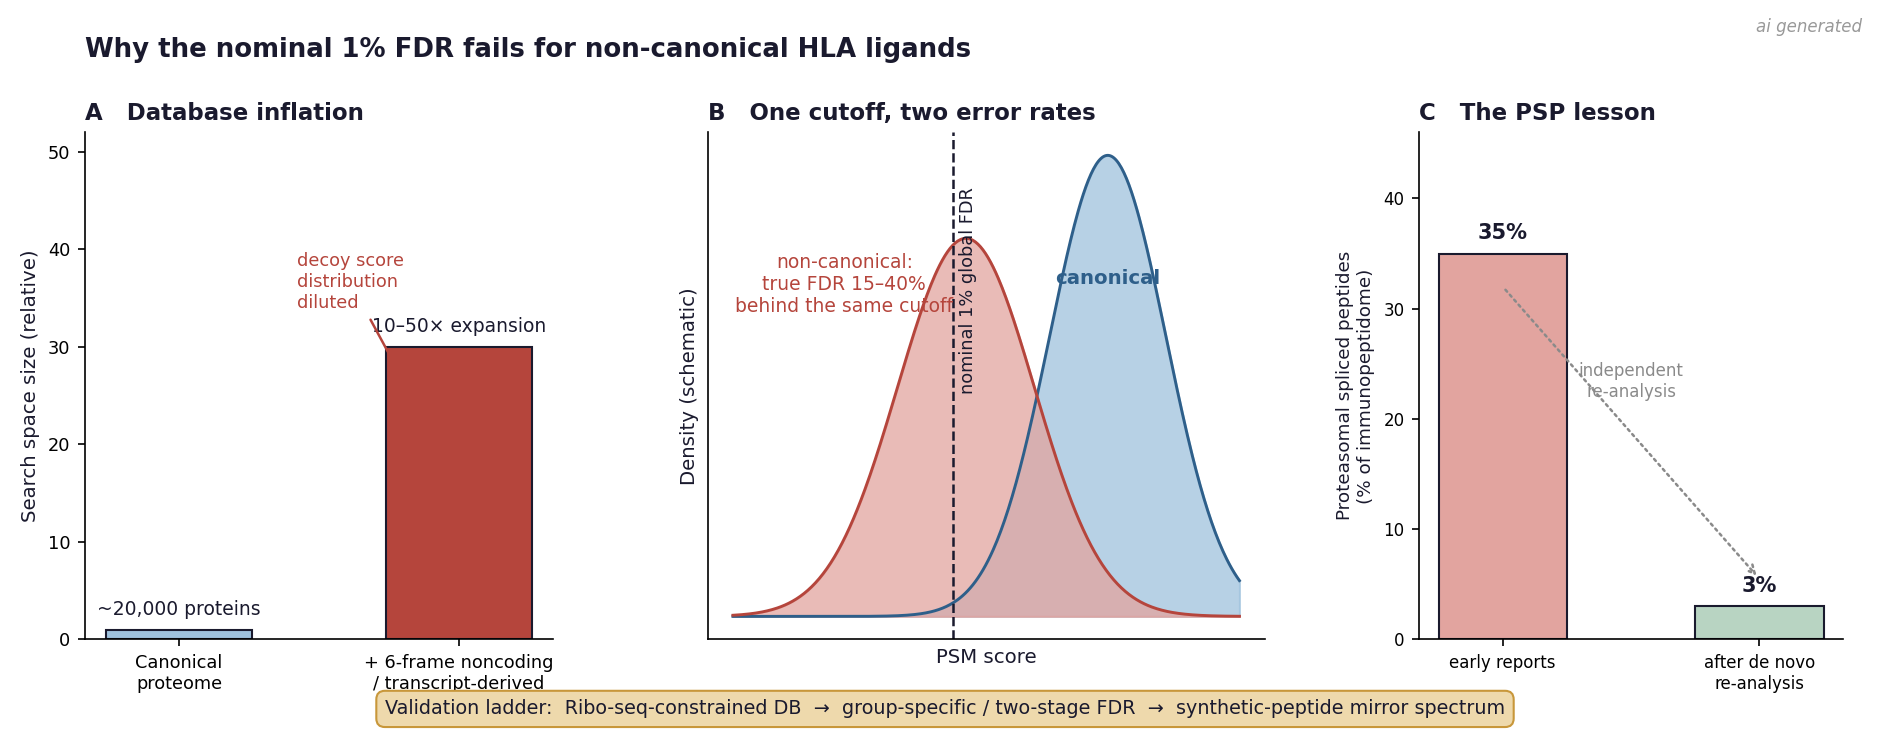
当检索空间因为并入六框翻译或转录组推导序列而膨胀十到五十倍时,诱饵库的得分分布被稀释,名义上1%的全局FDR在非经典这一类里可能对应着百分之十几到几十的真实错误率;经典的教训是蛋白酶体剪接肽——早期报告称其占免疫肽组的三到四成,经过独立的从头测序与重新检索后,上界被压到约3%[6]。同一篇综述还指出,非经典候选完全可以由一条带了未计入修饰的经典肽产生,一条看似新颖的谱图其实只是被误配的旧序列;而对非经典序列做多级FDR时会引入另一种偏差,因为一条本属非经典的谱图可能在第一级里被错误地归给经典肽,从此退出后续分析[6]。学术界的应对是分层处理:经典与非经典分别算FDR(separate FDR),或分级检索(multistage FDR);Ribo-seq约束的数据库优先于单纯RNA-seq推导的序列;最终的裁决权交给稳定同位素标记合成肽的镜像谱图比对。髓母细胞瘤的最新工作即按两级检索执行,第一级用5%分组FDR缩库,第二级在缩小后的库里用1%分组FDR定稿[7]。
把两条路线的假阳性摊开对照,会发现它们几乎不重叠。功能筛选会因为你把抗原表达得太高而骗你,免疫肽组学会因为你的数据库太大而骗你;前者漏掉弱激动剂,后者漏掉低丰度配体——而低丰度恰恰是隐匿抗原的常态,这也是为什么Ely等人要动用类器官做高深度采集。反过来,功能筛选天然免疫于数据库问题,因为它的答案由细胞的表型给出,不由打分函数给出;免疫肽组学天然免疫于过表达问题,因为它测的是真核细胞在真实调控下装上去的肽。真正的互补性就在这里:一个负责证明”这确实是天然呈递的”,一个负责证明”这确实能杀死细胞”。Schumacher与Scheper等人综述大规模TCR筛选时给出的判断也指向同一点——高通量筛选把抗原特异性图谱的深度推到了前所未有的水平,但它的输出仍然需要免疫肽组学式的天然性证据来锚定[8]。
非经典抗原的产能瓶颈正在两条路线之间移动。免疫肽组学这一侧的瓶颈是灵敏度与统计,质谱能测到的隐匿肽数量受限于配体丰度与检索策略,髓母细胞瘤研究中筛出的癌限制性候选不足六百条,作者自己承认偏低,归因于质谱灵敏度与策略限制[7];随着Astral一类高分辨仪器与更严格的分组FDR普及,这一侧会持续放量。功能筛选这一侧的瓶颈则从”能不能筛”变成了”筛出来之后怎么算”。Spindler等人用微流控把天然配对的TCRαβ库做到290万克隆型,能从频率低于十万分之一的群体里捞出抗原反应性TCR[9];Permutatrix式的思路则把这一逻辑推到极致——把肽-MHC的编码信息与TCR配对信息直接绑在读数上,一次实验同时读出抗原与TCR,正是Ely等人所依赖的那类条码映射的通用化形式。当TCR这一侧可以百万级并行地读出,抗原发现的限制条件就退回到”你往体系里放了什么候选”。而候选从哪来,答案仍然是免疫肽组学,或者更准确地说,是先有免疫肽组学把非经典空间里的可呈递序列捞出来,再有功能平台把它们与真实TCR配对。
这也解释了为什么TScan公司把III期停下来也不是方法学的失败。ALLOHA那一批数据里,HA-2这个靶点恰恰是”先有质谱证据、后有TCR”的老派路线产物:2001年的工作用质谱证明V等位肽被天然呈递、M等位肽不被呈递,单残基之差决定了呈递的有无,这个结果是免疫肽组学给出的,随后才是TCR的分离与改造。TScan的技术护城河在抗原发现的上游,而它暂停的是下游的临床开发——两件事在方法学上并不冲突,只是资本市场的耐心比特异性图谱的产能短得多。
如果要说这两条路线最终会以什么形式合流,笔者的判断是”筛出来的候选必须回到配体证据,捞出来的配体必须回到功能证据”,二者互为对方的质控。
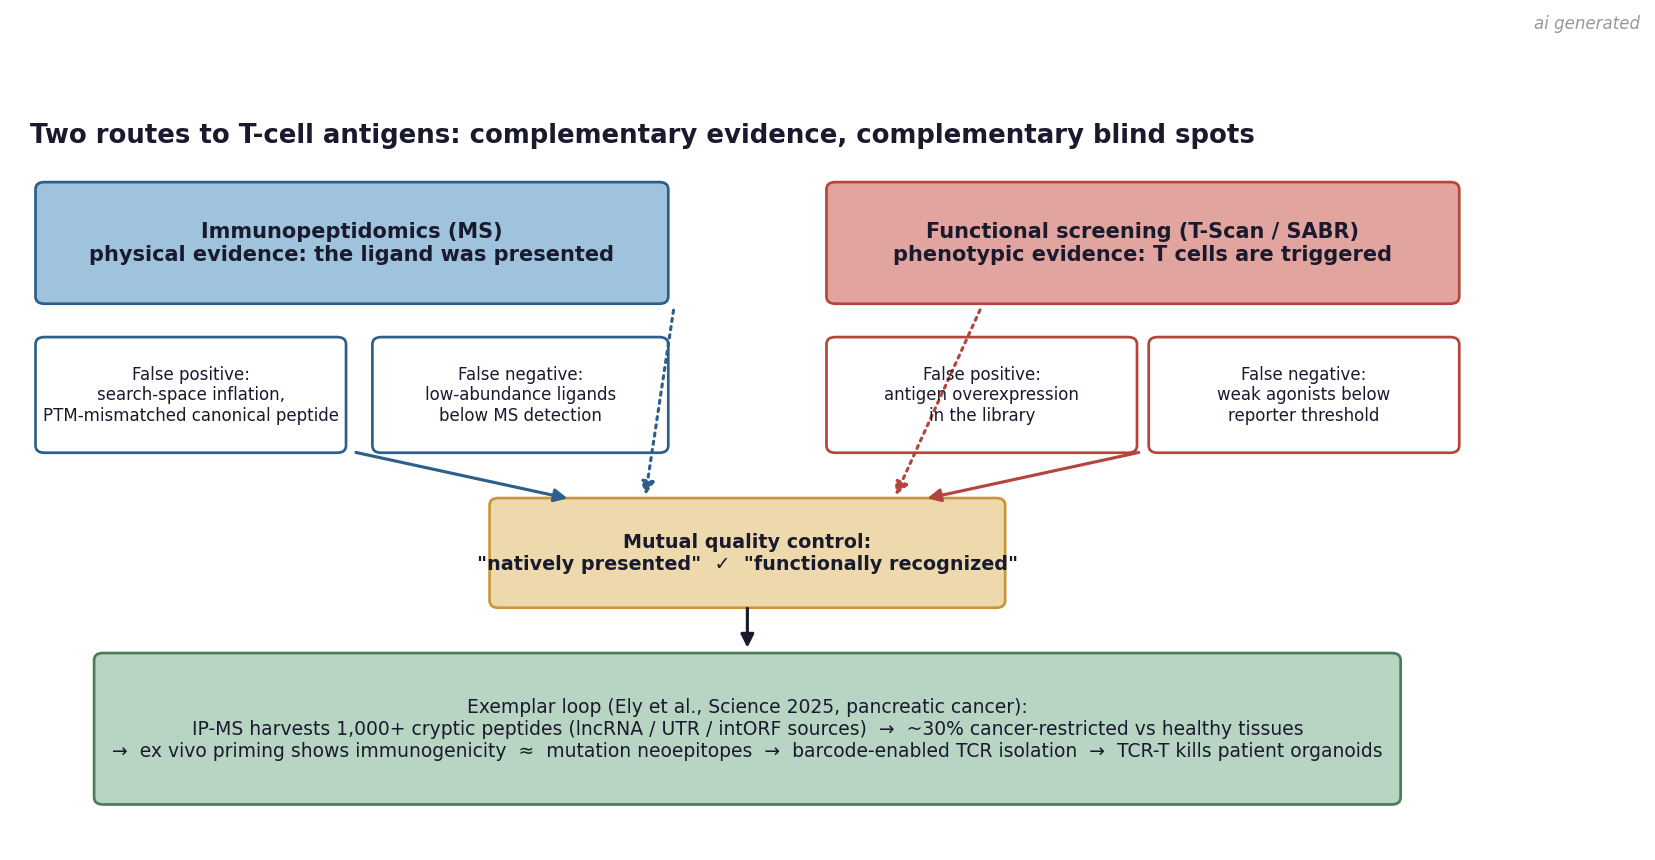
非经典抗原的领域尤应如此,因为这一类抗原的两侧偏差恰好被放大:免疫肽组学在这里最容易因检索空间而虚高,功能筛选在这里最容易因过表达而虚高。落到操作层面,一个可以执行的纪律是——免疫肽组学一侧,非经典候选除非拿到合成肽镜像谱图,否则不应进入靶点清单;功能筛选一侧,除非能证明在生理表达水平下仍可识别,否则不应进入临床候选。这两条纪律都不便宜,但它们比任何一条单独路线的漂亮数字都更接近真相。
| 维度 | 免疫肽组学 | 功能筛选(T-Scan/SABR 一路) |
|---|---|---|
| 证据类型 | 物理呈递(质谱直接测到 HLA 配体) | 功能识别(颗粒酶 B 报告基因读出真实信号通路) |
| 回答的问题 | 什么被呈递了 | 什么能激活 T 细胞 |
| 主要假阳性机制 | 检索空间膨胀致 FDR 失真;修饰肽误配;剪接肽式误判 | 抗原过表达;报告体系对弱激动剂的假命中 |
| 主要假阴性机制 | 低丰度配体低于检出限;隐性等位基因 | 弱亲和力肽低于报告阈值;非 CD8 通路未覆盖 |
| 非经典抗原上的表现 | 唯一能无需先验地捞出候选;但需分组 FDR 与合成肽验证 | 天然规避数据库问题;但受生理表达水平质疑 |
| 质控最低要求 | 分组/分级 FDR、Ribo-seq 约束库、合成肽镜像谱图 | 生理表达水平复现、表位足迹合理、内源靶点杀伤验证 |
参考文献
- Joglekar AV, Leonard MT, Jeppson JD, et al. T cell antigen discovery via signaling and antigen-presenting bifunctional receptors. Nature Methods 2019;16(2):191-198. DOI: 10.1038/s41592-018-0304-8.
- Kula T, Dezfulian MH, Wang CI, et al. T-Scan: A Genome-wide Method for the Systematic Discovery of T Cell Epitopes. Cell 2019;178(4):1016-1028.e13. DOI: 10.1016/j.cell.2019.07.009.
- Dezfulian MH, Kula T, Pranzatelli T, et al. TScan-II: A genome-scale platform for the de novo identification of CD4+ T cell epitopes. Cell 2023;186(25):5569-5586.e21. DOI: 10.1016/j.cell.2023.10.024.
- Ely ZA, Kulstad ZJ, Gunaydin G, et al. Pancreatic cancer-restricted cryptic antigens are targets for T cell recognition. Science 2025;388(6747):eadk3487. DOI: 10.1126/science.adk3487.
- Ferretti AP, Kula T, Wang Y, et al. Unbiased Screens Show CD8+ T Cells of COVID-19 Patients Recognize Shared Epitopes in SARS-CoV-2 that Largely Reside outside the Spike Protein. Immunity 2020;53(5):1095-1107.e3. DOI: 10.1016/j.immuni.2020.10.006.
- Wang Y, Zhang H, Wang G, et al. Current perspectives on mass spectrometry-based immunopeptidomics: the computational angle to tumor antigen discovery. Journal for ImmunoTherapy of Cancer 2023;11(9):e007073. DOI: 10.1136/jitc-2023-007073.
- Zheng N, Xu Y, Mai W, Hui A. Integrated immunopeptidomics and transcriptomics reveal a cancer-restricted non-canonical HLA class I ligandome in medulloblastoma. bioRxiv 2026. DOI: 10.64898/2026.09.26.754718.
- Moravec Ž, Haanen JBAG, Schumacher TN, Scheper W. Learning the language of T cell receptors through large-scale screening. Cancer Cell 2025;43(6):993-997. DOI: 10.1016/j.ccell.2025.03.032.
- Spindler MJ, Nelson AL, Wagner EK, et al. Massively parallel interrogation and mining of natively paired human TCRαβ repertoires. Nature Biotechnology 2020;38(5):609-619. DOI: 10.1038/s41587-020-0438-y.
内容经AI校正和润色,审慎阅读